# ImageGPT
## 概要
ImageGPTモデルは、Mark Chen、Alec Radford、Rewon Child、Jeffrey Wu、Heewoo Jun、David Luan、Ilya Sutskeverによる[Generative Pretraining from Pixels](https://openai.com/blog/image-gpt)で提案されました。ImageGPT (iGPT) は、次のピクセル値を予測するように学習されたGPT-2に似たモデルであり、無条件および条件付きの画像生成の両方を可能にします。
[論文](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V1_ICML.pdf)の抄録は以下の通りです:
*自然言語における教師なし表現学習の進歩に着想を得て、同様のモデルが画像に対して有用な表現を学習できるかどうかを検討しました。2次元入力構造に関する知識を組み込まずに、シーケンス Transformer を訓練してピクセルを自己回帰的に予測させます。ラベルなしの低解像度 ImageNet で訓練したにもかかわらず、GPT-2 規模のモデルは、線形プローブ、ファインチューニング、および低データ分類によって測定される強力な画像表現を学習していることがわかりました。CIFAR-10 では、線形プローブで 96.3% の精度を達成し、教師あり Wide ResNet を上回り、完全なファインチューニングでは 99.0% の精度を達成し、上位の教師あり事前学習モデルと同等の性能を示しました。また、VQVAE エンコーディングにピクセルを置き換えた場合、ImageNet における自己教師ありベンチマークと競争力があり、特徴の線形プローブでトップ 1 精度 69.0% を達成しました。*
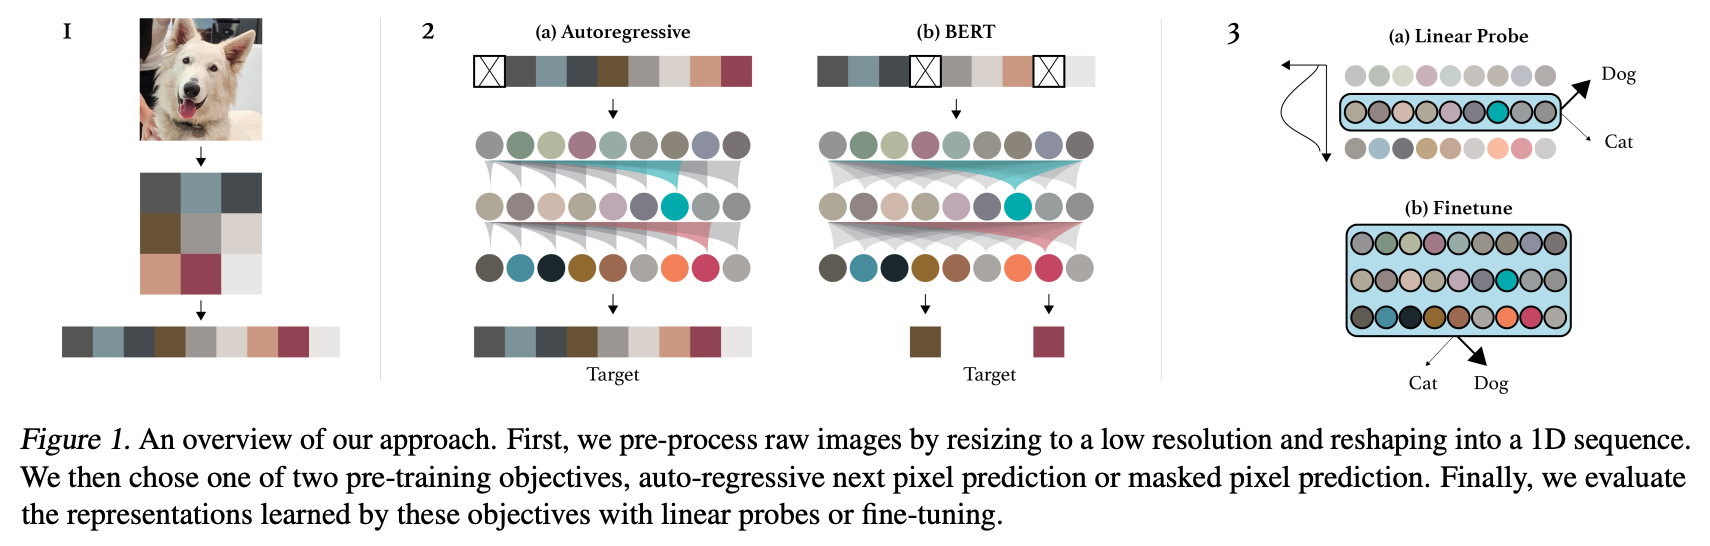 アプローチの概要。[元の論文](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V2.pdf)より引用。
このモデルは、[このイシュー](https://github.com/openai/image-gpt/issues/7)に基づいて[nielsr](https://huggingface.co/nielsr)によって貢献されました。元のコードは[こちら](https://github.com/openai/image-gpt)で確認できます。
## 使用のコツ
- ImageGPTは[GPT-2](gpt2)とほぼ同一ですが、異なる活性化関数(具体的には"quick gelu")が使用され、層正規化レイヤーが入力の平均をゼロにしない点が異なります。また、ImageGPTは入力と出力の埋め込みの共有(tied embeddings)を行いません。
- Transformers のアテンション機構の時間とメモリ要件はシーケンス長の2乗に比例して増加するため、著者は 32x32 や 64x64 といった小さな入力解像度で ImageGPT を事前学習しました。しかし、0..255 の 32x32x3=3072 トークンのシーケンスを Transformer に与えることは依然として計算コストが大きすぎます。そこで、著者は (R,G,B) ピクセル値に対して k=512 の k-means クラスタリングを適用しました。これにより、シーケンス長は 32*32 = 1024 に短縮されますが、値の範囲は 0..511 の整数になります。つまり、埋め込み行列が大きくなることを代償にシーケンス長を縮小していることになります。言い換えれば、ImageGPT の語彙サイズは 512 に、すべてのシーケンスの先頭で使用される特別な「文の開始」(SOS) トークンを 1 つ加えたものになります。モデル用の画像の準備には [ImageGPTImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTImageProcessor) を使用できます。
- 完全に教師なし(つまり、ラベルを一切使用せずに)事前学習されているにもかかわらず、ImageGPT は、画像分類などの下流タスクに有用な、かなり高性能な画像特徴量を生成します。著者らは、ネットワークの中間層の特徴量が最も高性能であり、それらをそのまま使って線形モデル(例えば、sklearn のロジスティック回帰モデルなど)を訓練できることを示しました。これは「linear probing」とも呼ばれます。特徴量は、まず画像をモデルにフォワードし、次に`output_hidden_states=True`を指定し、最後に任意の層の隠れ状態を平均プーリングすることで、簡単に取得できます。
- 代わりに、BERTと同様に、下流のデータセットでモデル全体をさらにファインチューニングすることもできます。これには、[ImageGPTForImageClassification](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTForImageClassification)を使用できます。
- ImageGPTには異なるサイズがあり、ImageGPT-small、ImageGPT-medium、ImageGPT-largeがあります。著者らはXLバリアントも訓練しましたが、公開はしていません。サイズの違いは以下の表にまとめられています。
| **モデルのバリアント** | **深度** | **隠れ層サイズ** | **デコーダーの隠れ層サイズ** | **パラメータ数 (M)** | **ImageNet-1k Top 1** |
|---|---|---|---|---|---|
| MiT-b0 | [2, 2, 2, 2] | [32, 64, 160, 256] | 256 | 3.7 | 70.5 |
| MiT-b1 | [2, 2, 2, 2] | [64, 128, 320, 512] | 256 | 14.0 | 78.7 |
| MiT-b2 | [3, 4, 6, 3] | [64, 128, 320, 512] | 768 | 25.4 | 81.6 |
| MiT-b3 | [3, 4, 18, 3] | [64, 128, 320, 512] | 768 | 45.2 | 83.1 |
| MiT-b4 | [3, 8, 27, 3] | [64, 128, 320, 512] | 768 | 62.6 | 83.6 |
| MiT-b5 | [3, 6, 40, 3] | [64, 128, 320, 512] | 768 | 82.0 | 83.8 |
## リソース
ImageGPTの入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示されます)のリソースのリストです。
- ImageGPTのデモノートブックは[こちら](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ImageGPT)で確認できます。
- [ImageGPTForImageClassification](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTForImageClassification) は、この [ノートブック](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb) でサポートされています。
- 関連項目: [画像分類タスクガイド](../tasks/image_classification)
ここにリソースを掲載していただくことを希望される場合は、Pull Request を開いてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しいものを示すことが望ましいです。
## ImageGPTConfig[[transformers.ImageGPTConfig]]
#### transformers.ImageGPTConfig[[transformers.ImageGPTConfig]]
```python
transformers.ImageGPTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 513, n_positions: int = 1024, n_embd: int = 512, n_layer: int = 24, n_head: int = 8, n_inner: int | None = None, activation_function: str = 'quick_gelu', resid_pdrop: float | int = 0.1, embd_pdrop: float | int = 0.1, attn_pdrop: float | int = 0.1, layer_norm_epsilon: float = 1e-05, initializer_range: float = 0.02, scale_attn_weights: bool = True, use_cache: bool = True, tie_word_embeddings: bool = False, scale_attn_by_inverse_layer_idx: bool = False, reorder_and_upcast_attn: bool = False, add_cross_attention: bool = False, pad_token_id: int | None = None, bos_token_id: int | None = None, eos_token_id: int | list[int] | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/configuration_imagegpt.py#L24)
**パラメータ:**
vocab_size (`int`、*任意*、デフォルトは `513`) : モデルの語彙サイズ。`input_ids` で表現できるトークンの種類数を定義します。
n_positions (`int`、*任意*、デフォルトは`1024`) : このモデルが使用される可能性のある最大シーケンス長。
n_embd (`int`、*optional*、デフォルトは `512`) : 埋め込みおよび隠れ状態の次元数。
n_layer (`int`、*optional*、デフォルトは `24`) : Transformer デコーダーの隠れ層の数。
n_head (`int`、*任意*、デフォルトは `8`) : Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。
n_inner (`int`, *任意*) : MLP 表現の次元数。
activation_function (`str`、*任意*、デフォルトは `quick_gelu`) : デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、`"gelu"`、`"relu"`、`"silu"` など。
resid_pdrop (`Union[float, int]`、*任意*、デフォルト値は`0.1`) : embeddings、encoder、pooler 内のすべての全結合層における dropout 確率。
embd_pdrop (`Union[float, int]`、*任意*、デフォルトは `0.1`) : 埋め込みの dropout 率。
attn_pdrop (`Union[float, int]`、*任意*、デフォルトは`0.1`) : 注意確率のドロップアウト率。
layer_norm_epsilon (`float`、*任意*、デフォルトは`1e-05`) : Layer Normalization 層で使用する epsilon。
initializer_range (`float`、*任意*、デフォルトは`0.02`) : すべての重み行列を初期化するためのtruncated_normal_initializerの標準偏差です。
scale_attn_weights (`bool`、*任意*、デフォルトは`True`) : sqrt(d_model) で割って埋め込みをスケーリングするかどうか。
use_cache (`bool`、*任意*、デフォルトは `True`) : モデルが最後のキー/バリューアテンションを返すかどうか(すべてのモデルで利用されるわけではありません)。`config.is_decoder=True` の場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。
tie_word_embeddings (`bool`, *任意*, デフォルトは `False`) : モデルの `tied_weights_keys` マッピングに従って重み埋め込みを共有するかどうか。
scale_attn_by_inverse_layer_idx (`bool`、*任意*、デフォルトは`False`) : `1 / layer_idx + 1`でアテンション重みをさらにスケーリングするかどうか。
reorder_and_upcast_attn (`bool`、*任意*、デフォルトは`False`) : 混合精度で学習を行う場合、アテンション(ドット積)を計算する前にキー(K)をスケーリングし、アテンションのドット積/softmaxをfloat()にアップキャストするかどうかを指定します。
add_cross_attention (`bool`、*任意*、デフォルトは`False`) : モデルにクロスアテンション層を追加するかどうか。
pad_token_id (`int`, *任意*) : 語彙内でパディングに使用されるトークンID。
bos_token_id (`int`, *任意*) : 語彙内でストリームの開始に使用されるトークン ID。
eos_token_id (`Union[int, list[int]]`、*任意*) : 語彙内でストリームの終了に使用されるトークン ID。
これは ImageGPTModel の設定を保存するための設定クラスです。指定された引数に基づいて Imagegpt モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[openai/imagegpt-small](https://huggingface.co/openai/imagegpt-small) と同様の設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import ImageGPTConfig, ImageGPTModel
>>> # Initializing a ImageGPT configuration
>>> configuration = ImageGPTConfig()
>>> # Initializing a model (with random weights) from the configuration
>>> model = ImageGPTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
#### transformers.ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
```python
transformers.ImageGPTImageProcessor(clusters: typing.Union[list, numpy.ndarray, torch.Tensor, NoneType] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/image_processing_imagegpt.py#L82)
**パラメータ:**
clusters (`np.ndarray` または `list[list[int]]` または `torch.Tensor`、*任意*) : カラー量子化時に使用するカラークラスタで、形状は `(n_clusters, 3)` です。`preprocess` 内の `clusters` によって上書きできます。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *任意*, デフォルトは `True`) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は`{'height' : 256, 'width': 256}`): モデルへの最大入力サイズを指定します。
default_to_square (`bool`, *kwargs*, *任意*、デフォルトは `True`) : size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*、デフォルト値は`2`) : 画像のリサイズ時に使用するリサンプリングフィルタです。これは列挙型`PILImageResampling`のいずれかになります。`do_resize`が`True`に設定されている場合のみ、効果が現れます。
do_rescale (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*, デフォルトは `0.00392156862745098`) : `do_rescale` が `True` に設定されている場合、画像をリスケールするための係数。
do_normalize (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.5, 0.5, 0.5]`) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.5, 0.5, 0.5]`) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
clusters (`np.ndarray`、*kwargs*、または `list[list[int]]`、または `torch.Tensor`、*任意*、デフォルトは `self.clusters`) : カラー量子化を行う際に使用するカラークラスタで、形状は `(n_clusters, 3)` です。`preprocess` 内の `clusters` によって上書きできます。
do_color_quantize (`bool`, *kwargs*, *optional*, デフォルトは `self.do_color_quantize`) : 連続的なピクセル値を離散的なクラスタインデックスに変換するためにカラー量子化を適用するかどうかを制御します。True の場合、各ピクセルは最も近いカラークラスタに割り当てられ、ImageGPT の離散的なトークンモデリングが可能になります。
ImageGPTImageProcessor イメージプロセッサを構築します。
#### preprocess[[transformers.ImageGPTImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 前処理対象の画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
image_like_kwargs (`dict[str, Any]`、*省略可*) : 追加の画像類似の入力も前処理対象にするための開発者向けフラグです。引数として kwarg を渡す方法が機能しない場合のみ使用してください。例えば、`preprocess(images, masks=masks)` が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりに `preprocess(images, image_like_inputs={"masks": masks})` を使用できます。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *optional*) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 画像をリサイズする場合に使用するリサンプリングフィルタ。`PILImageResampling` の列挙型のいずれかです。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *任意*) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*) : `do_rescale` が `True` に設定されている場合、画像をリサイズするためのリスケール係数。
do_normalize (`bool`, *kwargs*, *optional*) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
**戻り値:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ メソッドによって返されるリスト/配列/テンソルの辞書('pixel_values' など)。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
## ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
#### transformers.ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
```python
transformers.ImageGPTImageProcessorPil(clusters: list | np.ndarray | torch.Tensor | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/image_processing_pil_imagegpt.py#L69)
**パラメータ:**
clusters (`np.ndarray` または `list[list[int]]` または `torch.Tensor`、*任意*) : カラー量子化時に使用するカラークラスタで、形状は `(n_clusters, 3)` です。`preprocess` 内の `clusters` によって上書きできます。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *任意*, デフォルトは `True`) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は`{'height' : 256, 'width': 256}`): モデルへの最大入力サイズを指定します。
default_to_square (`bool`, *kwargs*, *任意*、デフォルトは `True`) : size が整数の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*、デフォルト値は`2`) : 画像のリサイズ時に使用するリサンプリングフィルタです。これは列挙型`PILImageResampling`のいずれかになります。`do_resize`が`True`に設定されている場合のみ、効果が現れます。
do_rescale (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*, デフォルトは `0.00392156862745098`) : `do_rescale` が `True` に設定されている場合、画像をリスケールするための係数。
do_normalize (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.5, 0.5, 0.5]`) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.5, 0.5, 0.5]`) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
clusters (`np.ndarray`、*kwargs*、または `list[list[int]]`、または `torch.Tensor`、*任意*、デフォルトは `self.clusters`) : カラー量子化を行う際に使用するカラークラスタで、形状は `(n_clusters, 3)` です。`preprocess` 内の `clusters` によって上書きできます。
do_color_quantize (`bool`, *kwargs*, *optional*, デフォルトは `self.do_color_quantize`) : 連続的なピクセル値を離散的なクラスタインデックスに変換するためにカラー量子化を適用するかどうかを制御します。True の場合、各ピクセルは最も近いカラークラスタに割り当てられ、ImageGPT の離散的なトークンモデリングが可能になります。
ImageGPTImageProcessor イメージプロセッサを構築します。
#### preprocess[[transformers.ImageGPTImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 前処理対象の画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
image_like_kwargs (`dict[str, Any]`、*省略可*) : 追加の画像類似の入力も前処理対象にするための開発者向けフラグです。引数として kwarg を渡す方法が機能しない場合のみ使用してください。例えば、`preprocess(images, masks=masks)` が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりに `preprocess(images, image_like_inputs={"masks": masks})` を使用できます。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *optional*) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 画像をリサイズする場合に使用するリサンプリングフィルタ。`PILImageResampling` の列挙型のいずれかです。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *任意*) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*) : `do_rescale` が `True` に設定されている場合、画像をリサイズするためのリスケール係数。
do_normalize (`bool`, *kwargs*, *optional*) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
**戻り値:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ メソッドによって返されるリスト/配列/テンソルの辞書('pixel_values' など)。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
## ImageGPTModel[[transformers.ImageGPTModel]]
#### transformers.ImageGPTModel[[transformers.ImageGPTModel]]
```python
transformers.ImageGPTModel(config: ImageGPTConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L393)
**パラメータ:**
config ([ImageGPTConfig](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
特定のヘッドを付加せずに、生のhidden-statesを出力する素のImagegptモデル。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.ImageGPTModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L416)
**パラメータ:**
input_ids (`torch.LongTensor`、shape `(batch_size, input_ids_length)`) : `input_ids_length` = `past_key_values` が `None` の場合は `sequence_length`、それ以外の場合は `past_key_values.get_seq_length()`(入力された past key value states の `sequence_length`)。語彙における入力シーケンスのトークンインデックスです。 `past_key_values` を使用する場合、past が計算されていない `input_ids` のみを `input_ids` として渡す必要があります。 インデックスは [AutoImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoImageProcessor) を使用して取得できます。 詳細は [ImageGPTImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください。
past_key_values (`~cache_utils.Cache`, *任意*) : 逐次デコードを高速化するために使用できる、事前計算された hidden-states(self-attention ブロックおよび cross-attention ブロック内の key と value)です。通常、`use_cache=True` または `config.use_cache=True` の場合、モデルがデコードの以前の段階で返した `past_key_values` で構成されます。入力として許可されるのは [Cache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.Cache) インスタンスのみです。[kv cache ガイド](https://huggingface.co/docs/transformers/en/kv_cache)を参照してください。`past_key_values` が渡されない場合、デフォルトで [DynamicCache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.DynamicCache) が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。`past_key_values` を使用する場合は、すべての `input_ids`(形状 `(batch_size, sequence_length)`)の代わりに、このモデルに過去の key value 状態が与えられていない未処理の `input_ids`(形状 `(batch_size, unprocessed_length)`)のみを入力する必要があります。
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
position_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。`[0, config.n_positions - 1]` の範囲から選択されます。 [位置 ID とは何か?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
encoder_hidden_states (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`、*任意*) : エンコーダーの最終層の出力における隠れ状態のシーケンス。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。
encoder_attention_mask (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : エンコーダー入力のpaddingトークンインデックスに対するattentionの実行を回避するためのマスクです。モデルがデコーダーとして設定されている場合、このマスクはcross-attentionで使用されます。`[0, 1]`から選択されるマスクの値: - **マスクされない**トークンは1、 - **マスクされる**トークンは0。
use_cache (`bool`, *任意*) : `True`に設定すると、`past_key_values`のキーバリュー状態が返され、デコーディングの高速化に利用できます(`past_key_values`を参照)。
output_attentions (`bool`, *任意*) : すべてのアテンション層のアテンションテンソルを返すかどうか。詳細は、返されるテンソルの `attentions` を参照してください。
output_hidden_states (`bool`, *任意*) : 全レイヤーの hidden states を返すかどうかを指定します。詳細は、返されるテンソルの `hidden_states` を参照してください。
return_dict (`bool`, *任意*) : プレーンなタプルではなく [ModelOutput](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.utils.ModelOutput) を返すかどうか。
**戻り値:** [BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) または `tuple(torch.Tensor)`
設定([ImageGPTConfig](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTConfig))と入力に応じて、さまざまな要素で構成される、[BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
[ImageGPTModel](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTModel)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`) -- モデルの最終層の出力における隠れ状態のシーケンス。
`past_key_values`が使用されている場合、出力されるのは、形状`(batch_size, 1, hidden_size)`のシーケンスの最後の隠れ状態のみです。
- **past_key_values** (`Cache`、*任意*、`use_cache=True` が渡された場合または `config.use_cache=True` の場合に返されます) -- [Cache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.Cache) のインスタンスです。詳細については、[kv cache ガイド](https://huggingface.co/docs/transformers/en/kv_cache)を参照してください。
自己アテンションブロック(および `config.is_encoder_decoder=True` の場合、クロスカレンションブロック)の事前計算済みヒドゥンステート(キーとバリュー)を保持します。これらは逐次デコーディングを高速化するために使用できます(`past_key_values` 入力参照)。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
- **cross_attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` と `config.add_cross_attention=True` が渡された場合、または `config.output_attentions=True` の場合に返されます) -- 各層に対応する `torch.Tensor` のタプルで、形状は `(batch_size, num_heads, sequence_length, sequence_length)` です。
クロスアテンション層のアテンション重みは、アテンションのsoftmax適用後に計算され、クロスアテンションヘッドにおける加重平均の計算に使用されます。
例:
```python
>>> from transformers import AutoImageProcessor, ImageGPTModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTModel.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
#### transformers.ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
```python
transformers.ImageGPTForCausalImageModeling(config: ImageGPTConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L594)
**パラメータ:**
config ([ImageGPTConfig](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
ImageGPT Modelは、入力埋め込みの重みと共有される線形層からなる言語モデリングヘッドを上部に備えたtransformerです。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.ImageGPTForCausalImageModeling.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L605)
**パラメータ:**
input_ids (`torch.LongTensor`、shape `(batch_size, input_ids_length)`) : `input_ids_length` = `past_key_values` が `None` の場合は `sequence_length`、それ以外の場合は `past_key_values.get_seq_length()`(入力された past key value states の `sequence_length`)。語彙における入力シーケンスのトークンインデックスです。 `past_key_values` を使用する場合、past が計算されていない `input_ids` のみを `input_ids` として渡す必要があります。 インデックスは [AutoImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoImageProcessor) を使用して取得できます。 詳細は [ImageGPTImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください。
past_key_values (`~cache_utils.Cache`, *任意*) : 逐次デコードを高速化するために使用できる、事前計算された hidden-states(self-attention ブロックおよび cross-attention ブロック内の key と value)です。通常、`use_cache=True` または `config.use_cache=True` の場合、モデルがデコードの以前の段階で返した `past_key_values` で構成されます。入力として許可されるのは [Cache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.Cache) インスタンスのみです。[kv cache ガイド](https://huggingface.co/docs/transformers/en/kv_cache)を参照してください。`past_key_values` が渡されない場合、デフォルトで [DynamicCache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.DynamicCache) が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。`past_key_values` を使用する場合は、すべての `input_ids`(形状 `(batch_size, sequence_length)`)の代わりに、このモデルに過去の key value 状態が与えられていない未処理の `input_ids`(形状 `(batch_size, unprocessed_length)`)のみを入力する必要があります。
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
position_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。`[0, config.n_positions - 1]` の範囲から選択されます。 [位置 ID とは何か?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
encoder_hidden_states (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`、*任意*) : エンコーダーの最終層の出力における隠れ状態のシーケンス。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。
encoder_attention_mask (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : エンコーダー入力のpaddingトークンインデックスに対するattentionの実行を回避するためのマスクです。モデルがデコーダーとして設定されている場合、このマスクはcross-attentionで使用されます。`[0, 1]`から選択されるマスクの値: - **マスクされない**トークンは1、 - **マスクされる**トークンは0。
labels (`torch.LongTensor`、shape `(batch_size, input_ids_length)`、*任意*) : 言語モデリング用のラベル。モデル内部でラベルは**シフト**されるため、`labels = input_ids`と設定できます。インデックスは`[-100, 0, ..., config.vocab_size]`から選択されます。`-100`に設定されたすべてのラベルは無視(マスク)され、損失は`[0, ..., config.vocab_size]`のラベルに対してのみ計算されます。
use_cache (`bool`, *任意*) : `True`に設定すると、`past_key_values`のキーバリュー状態が返され、デコーディングの高速化に利用できます(`past_key_values`を参照)。
output_attentions (`bool`, *任意*) : すべてのアテンション層のアテンションテンソルを返すかどうか。詳細は、返されるテンソルの `attentions` を参照してください。
output_hidden_states (`bool`, *任意*) : 全レイヤーの hidden states を返すかどうかを指定します。詳細は、返されるテンソルの `hidden_states` を参照してください。
return_dict (`bool`, *任意*) : プレーンなタプルではなく [ModelOutput](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.utils.ModelOutput) を返すかどうか。
**戻り値:** [CausalLMOutputWithCrossAttentions](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) または `tuple(torch.Tensor)`
A [CausalLMOutputWithCrossAttentions](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) or a tuple of `torch.Tensor` (if `return_dict=False` is passed or when `config.return_dict=False`) comprising various elements depending on the configuration ([ImageGPTConfig](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTConfig)) and inputs.
[ImageGPTForCausalImageModeling](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTForCausalImageModeling) の forward メソッドは、`__call__` という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、形状 `(1,)`、*任意*、`labels` が指定された場合に返されます) -- 言語モデリングの損失(次のトークンの予測用)。
- **logits** (`torch.Tensor`、形状 `(batch_size, sequence_length, config.vocab_size)`) -- 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
- **cross_attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
クロスアテンションのsoftmax後の重み。クロスアテンションヘッドにおける加重平均の計算に使用されます。
- **past_key_values** (`Cache`、*任意*、`use_cache=True` が渡された場合または `config.use_cache=True` の場合に返されます) -- [Cache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.Cache) のインスタンスです。詳細については、[kv cache ガイド](https://huggingface.co/docs/transformers/en/kv_cache)を参照してください。
シーケンシャルなデコーディングを高速化するために使用できる(`past_key_values` 入力参照)、事前計算済みの hidden-states(アテンションブロック内のキーとバリュー)が含まれます。
例:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForCausalImageModeling
>>> import torch
>>> import matplotlib.pyplot as plt
>>> import numpy as np
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForCausalImageModeling.from_pretrained("openai/imagegpt-small")
>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
>>> model.to(device)
>>> # unconditional generation of 8 images
>>> batch_size = 4
>>> context = torch.full((batch_size, 1), model.config.vocab_size - 1) # initialize with SOS token
>>> context = context.to(device)
>>> output = model.generate(
... input_ids=context, max_length=model.config.n_positions + 1, temperature=1.0, do_sample=True, top_k=40
... )
>>> clusters = image_processor.clusters
>>> height = image_processor.size["height"]
>>> width = image_processor.size["width"]
>>> samples = output[:, 1:].detach().cpu().numpy()
>>> samples_img = [
... np.reshape(np.rint(127.5 * (clusters[s] + 1.0)), [height, width, 3]).astype(np.uint8) for s in samples
... ] # convert color cluster tokens back to pixels
>>> f, axes = plt.subplots(1, batch_size, dpi=300)
>>> for img, ax in zip(samples_img, axes):
... ax.axis("off")
... ax.imshow(img)
```
## ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
#### transformers.ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
```python
transformers.ImageGPTForImageClassification(config: ImageGPTConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L723)
**パラメータ:**
config ([ImageGPTConfig](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
画像分類ヘッド(線形層)を上部に備えた ImageGPT モデルの Transformer。[ImageGPTForImageClassification](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTForImageClassification) は、分類を行うために隠れ状態を平均プーリングします。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.ImageGPTForImageClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L733)
**パラメータ:**
input_ids (`torch.LongTensor`、shape `(batch_size, input_ids_length)`) : `input_ids_length` = `past_key_values` が `None` の場合は `sequence_length`、それ以外の場合は `past_key_values.get_seq_length()`(入力された past key value states の `sequence_length`)。語彙における入力シーケンスのトークンインデックスです。 `past_key_values` を使用する場合、past が計算されていない `input_ids` のみを `input_ids` として渡す必要があります。 インデックスは [AutoImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoImageProcessor) を使用して取得できます。 詳細は [ImageGPTImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください。
past_key_values (`~cache_utils.Cache`, *任意*) : 逐次デコードを高速化するために使用できる、事前計算された hidden-states(self-attention ブロックおよび cross-attention ブロック内の key と value)です。通常、`use_cache=True` または `config.use_cache=True` の場合、モデルがデコードの以前の段階で返した `past_key_values` で構成されます。入力として許可されるのは [Cache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.Cache) インスタンスのみです。[kv cache ガイド](https://huggingface.co/docs/transformers/en/kv_cache)を参照してください。`past_key_values` が渡されない場合、デフォルトで [DynamicCache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.DynamicCache) が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。`past_key_values` を使用する場合は、すべての `input_ids`(形状 `(batch_size, sequence_length)`)の代わりに、このモデルに過去の key value 状態が与えられていない未処理の `input_ids`(形状 `(batch_size, unprocessed_length)`)のみを入力する必要があります。
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
position_ids (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。`[0, config.n_positions - 1]` の範囲から選択されます。 [位置 ID とは何か?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
labels (`torch.LongTensor`、形状 `(batch_size,)`、*任意*) : シーケンス分類/回帰の損失を計算するためのラベル。インデックスは `[0, ..., config.num_labels - 1]` の範囲である必要があります。`config.num_labels == 1` の場合は回帰損失(平均二乗誤差)が計算され、`config.num_labels > 1` の場合は分類損失(クロスエントロピー)が計算されます。
use_cache (`bool`, *任意*) : `True`に設定すると、`past_key_values`のキーバリュー状態が返され、デコーディングの高速化に利用できます(`past_key_values`を参照)。
output_attentions (`bool`, *任意*) : すべてのアテンション層のアテンションテンソルを返すかどうか。詳細は、返されるテンソルの `attentions` を参照してください。
output_hidden_states (`bool`, *任意*) : 全レイヤーの hidden states を返すかどうかを指定します。詳細は、返されるテンソルの `hidden_states` を参照してください。
return_dict (`bool`, *任意*) : プレーンなタプルではなく [ModelOutput](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.utils.ModelOutput) を返すかどうか。
**戻り値:** `SequenceClassifierOutputWithPast` または `tuple(torch.Tensor)`
`SequenceClassifierOutputWithPast`、または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。設定([ImageGPTConfig](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTConfig))と入力に応じて、さまざまな要素で構成されます。
[ImageGPTForImageClassification](/docs/transformers/v5.23.0/ja/model_doc/imagegpt#transformers.ImageGPTForImageClassification) の forward メソッドは、`__call__` という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、shape `(1,)`、*optional*、`labels` が指定された場合に返されます) -- 分類損失(config.num_labels==1 の場合は回帰損失)。
- **logits** (`torch.Tensor`、形状 `(batch_size, config.num_labels)`) -- SoftMax 適用前の分類(または config.num_labels==1 の場合は回帰)スコア。
- **past_key_values** (`Cache`、*任意*、`use_cache=True` が渡された場合または `config.use_cache=True` の場合に返されます) -- [Cache](/docs/transformers/v5.23.0/ja/internal/generation_utils#transformers.Cache) のインスタンスです。詳細については、[kv cache ガイド](https://huggingface.co/docs/transformers/en/kv_cache)を参照してください。
逐次デコーディングを高速化するために使用できる(`past_key_values` 入力参照)、事前計算済みの隠れ状態(自己注意ブロックのキーとバリュー)が含まれます。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForImageClassification
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForImageClassification.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits = outputs.logits
```