# ViLT
## Ikhtisar
Model ViLT diusulkan dalam [ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision](https://huggingface.co/papers/2102.03334) oleh Wonjae Kim, Bokyung Son, Ildoo Kim. ViLT mengintegrasikan text embeddings ke dalam Vision Transformer (ViT), sehingga memungkinkan desain yang minimal untuk Vision-and-Language Pre-training (VLP).
Abstrak dari makalah tersebut adalah sebagai berikut:
*Pre-training Visi dan Bahasa (VLP) telah meningkatkan kinerja pada berbagai tugas turunan visi dan bahasa yang bersifat gabungan. Pendekatan saat ini untuk VLP sangat bergantung pada proses ekstraksi fitur gambar, sebagian besar melibatkan supervisi region (misalnya, deteksi objek) dan arsitektur konvolusional (misalnya, ResNet). Meskipun diabaikan dalam literatur, kami menemukan hal ini bermasalah dari segi (1) efisiensi/kecepatan, di mana sekadar mengekstrak fitur input membutuhkan komputasi jauh lebih banyak daripada langkah interaksi multimodal; dan (2) kekuatan ekspresif, karena dibatasi oleh kekuatan ekspresif dari embedder visual dan kosakata visual yang didefinisikan sebelumnya. Dalam makalah ini, kami menyajikan model VLP minimal, Vision-and-Language Transformer (ViLT), yang bersifat monolitik dalam arti bahwa pemrosesan input visual disederhanakan secara drastis menjadi hanya cara bebas konvolusi yang sama seperti yang kami gunakan untuk memproses input teks. Kami menunjukkan bahwa ViLT hingga puluhan kali lebih cepat daripada model VLP sebelumnya, namun dengan kinerja tugas turunan yang kompetitif atau lebih baik.*
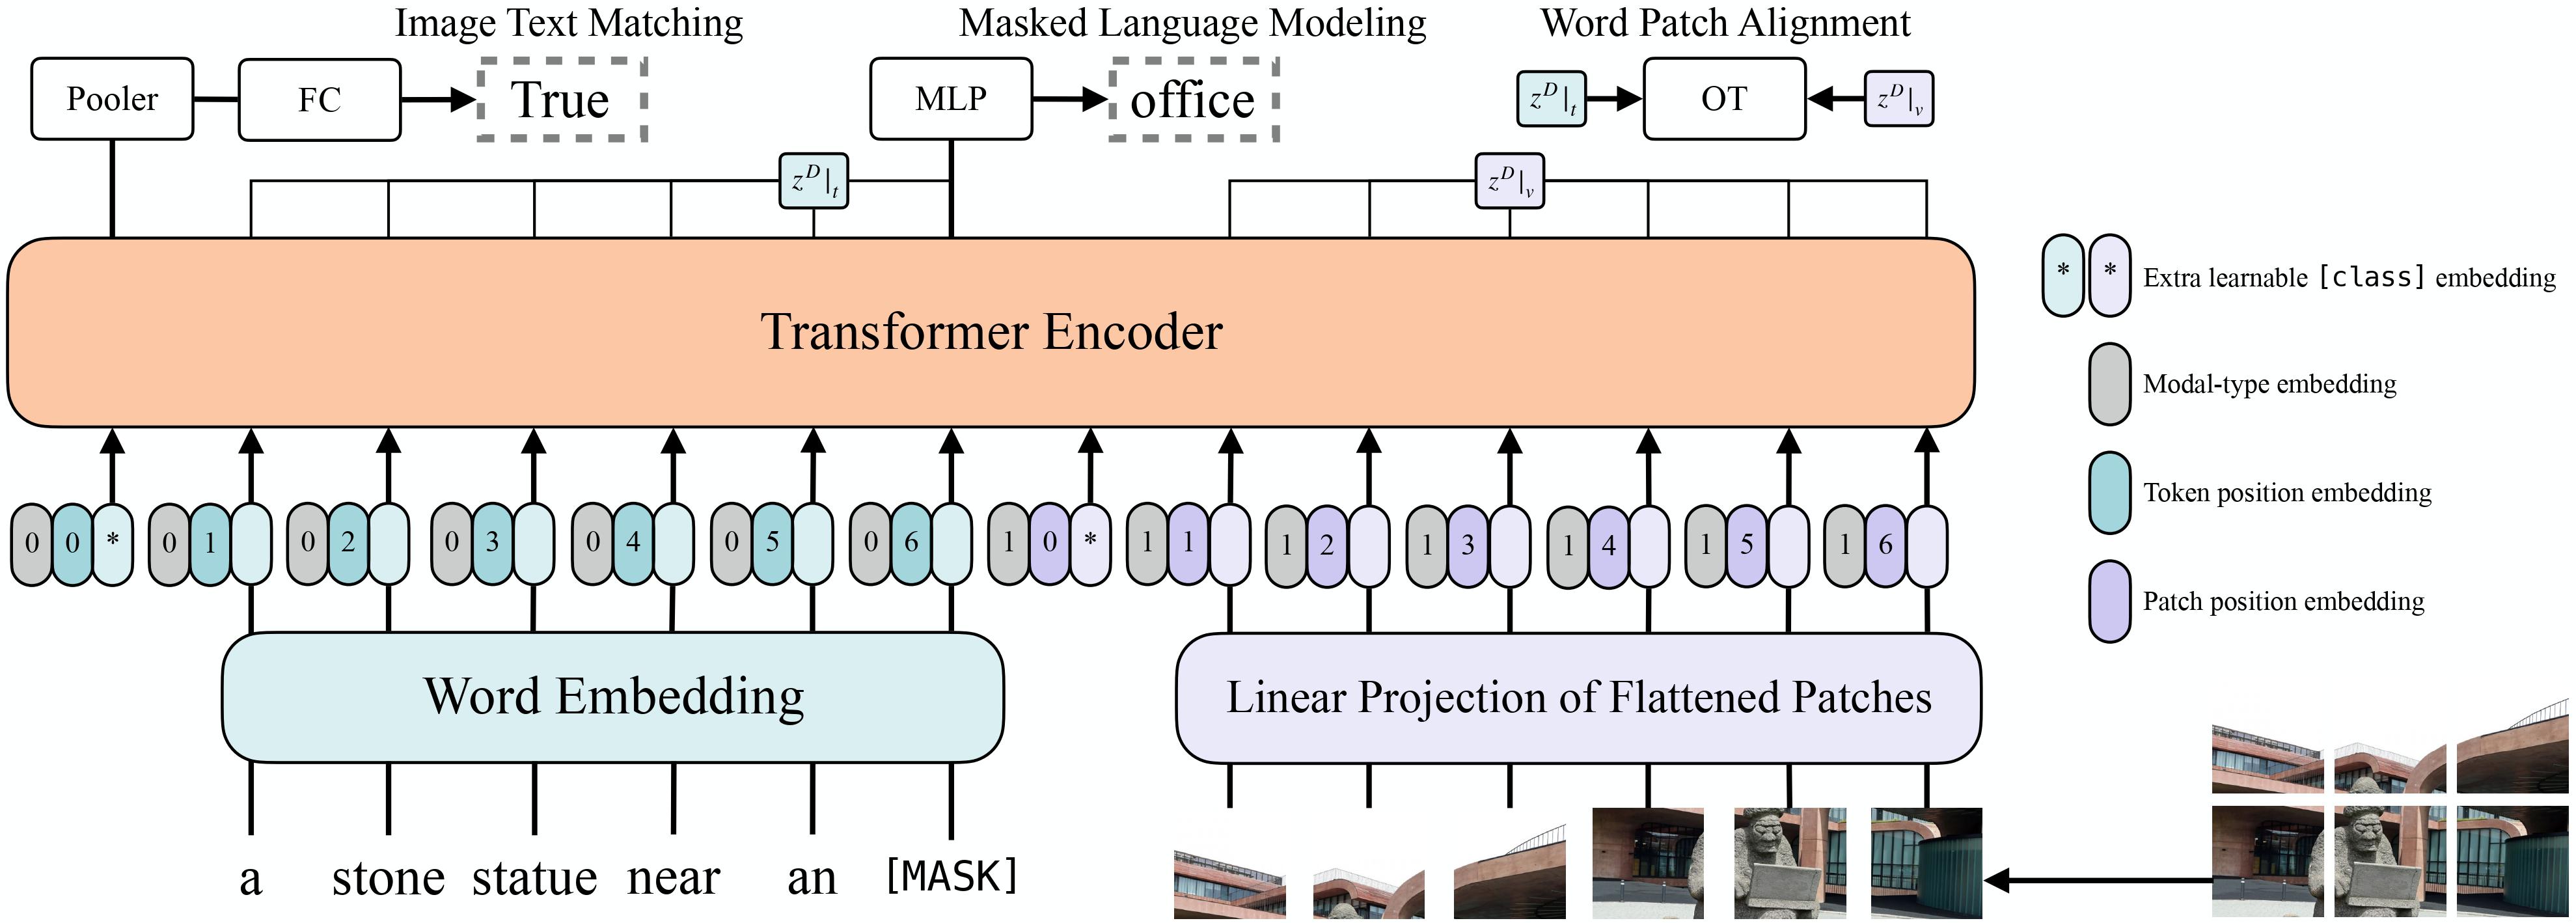 Arsitektur ViLT. Diambil dari paper aslinya.
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/dandelin/ViLT).
## Tips penggunaan
- Cara tercepat untuk memulai dengan ViLT adalah dengan memeriksa [notebook contoh](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ViLT) (yang menampilkan kedua inferensi dan fine-tuning pada data kustom).
- ViLT adalah model yang menerima `pixel_values` dan `input_ids` sebagai input. Anda dapat menggunakan [ViltProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltProcessor) untuk menyiapkan data bagi model. Prosesor ini membungkus image processor (untuk modalitas gambar) dan tokenizer (untuk modalitas bahasa) menjadi satu.
- ViVT dilatih dengan gambar berukuran beragam: para penulis mengubah ukuran sisi terpendek dari gambar input menjadi 384 dan membatasi sisi terpanjang di bawah 640 sambil mempertahankan rasio aspek. Agar pengelompokan (batching) gambar menjadi mungkin, para penulis menggunakan `pixel_mask` yang menunjukkan nilai piksel mana yang asli dan mana yang padding. [ViltProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltProcessor) secara otomatis membuat ini untuk Anda.
- Desain ViLT sangat mirip dengan Vision Transformer (ViT) standar. Satu-satunya perbedaan adalah model ini menyertakan lapisan embedding tambahan untuk modalitas bahasa.
## ViltConfig[[transformers.ViltConfig]]
#### transformers.ViltConfig[[transformers.ViltConfig]]
```python
transformers.ViltConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, type_vocab_size: int = 2, modality_type_vocab_size: int = 2, max_position_embeddings: int = 40, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 384, patch_size: int | list[int] | tuple[int, int] = 32, num_channels: int = 3, qkv_bias: bool = True, max_image_length: int = -1, tie_word_embeddings: bool = True, num_images: int = -1, pad_token_id: int | None = None)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/configuration_vilt.py#L24)
**Parameter:**
vocab_size (`int`, *opsional*, defaultnya `30522`) : Ukuran kosakata model. Menentukan jumlah token berbeda yang dapat direpresentasikan oleh `input_ids`.
type_vocab_size (`int`, *opsional*, defaultnya `2`) : Ukuran kosakata dari `token_type_ids`.
modality_type_vocab_size (`int`, *opsional*, default 2) : Ukuran kosakata dari modalitas yang dikirim saat memanggil [ViltModel](/docs/transformers/main/id/model_doc/vilt#transformers.ViltModel). Ini digunakan setelah menggabungkan embedding dari modalitas teks dan gambar.
max_position_embeddings (`int`, *opsional*, defaultnya `40`) : Panjang maksimum urutan yang mungkin akan digunakan dengan model ini.
hidden_size (`int`, *opsional*, defaultnya `768`) : Dimensi dari representasi tersembunyi.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `12`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
intermediate_size (`int`, *opsional*, defaultnya `3072`) : Dimensi dari representasi MLP.
hidden_act (`str`, *opsional*, defaultnya `gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
hidden_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Probabilitas dropout untuk semua lapisan fully connected di embeddings, encoder, dan pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-12`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
image_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `384`) : Ukuran (resolusi) dari setiap gambar.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `32`) : Ukuran (resolusi) dari setiap patch.
num_channels (`int`, *opsional*, default `3`) : Jumlah saluran input.
qkv_bias (`bool`, *opsional*, defaultnya `True`) : Apakah akan menambahkan bias ke queries, keys, dan values.
max_image_length (`int`, *opsional*, default -1) : Jumlah maksimum patch yang diambil sebagai input untuk encoder Transformer. Jika diatur ke bilangan bulat positif, encoder akan mengambil sampel `max_image_length` patch secara maksimum. Jika diatur ke -1, tidak akan diperhitungkan.
tie_word_embeddings (`bool`, *opsional*, defaultnya `True`) : Apakah mengikat embedding bobot sesuai dengan pemetaan `tied_weights_keys` model.
num_images (`int`, *opsional*, default -1) : Jumlah gambar yang digunakan untuk penalaran visual bahasa alami. Jika diatur ke bilangan bulat positif, nilai ini akan digunakan oleh [ViltForImagesAndTextClassification](/docs/transformers/main/id/model_doc/vilt#transformers.ViltForImagesAndTextClassification) untuk mendefinisikan kepala klasifikator.
pad_token_id (`int`, *opsional*) : ID token yang digunakan untuk padding dalam kosakata.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari ViltModel. Kelas ini digunakan untuk membuat instans model Vilt sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [dandelin/vilt-b32-mlm](https://huggingface.co/dandelin/vilt-b32-mlm)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import ViLTModel, ViLTConfig
>>> # Initializing a ViLT dandelin/vilt-b32-mlm style configuration
>>> configuration = ViLTConfig()
>>> # Initializing a model from the dandelin/vilt-b32-mlm style configuration
>>> model = ViLTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViltImageProcessor[[transformers.ViltImageProcessor]]
#### transformers.ViltImageProcessor[[transformers.ViltImageProcessor]]
```python
transformers.ViltImageProcessor(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/image_processing_vilt.py#L52)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'shortest_edge' : 384}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `3`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini seharusnya diatur sebagai atribut prosesor pada model-model mendatang. Mengembalikan tensor bertumpuk jika diatur ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini seharusnya diatur sebagai atribut prosesor pada model-model mendatang. Mengembalikan tensor bertumpuk jika diatur ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini seharusnya diatur sebagai atribut prosesor pada model-model mendatang. Mengembalikan tensor bertumpuk jika diatur ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
Mengembalikan tensor bertumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor. --
Membangun pemroses gambar ViltImageProcessor.
disable_grouping (`bool`, *kwargs*, *opsional*): Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan bukan dalam batch. Jika None, akan diatur ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157 image_seq_length (`int`, *kwargs*, *opsional*): Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini seharusnya diatur sebagai atribut prosesor pada model-model mendatang.
#### preprocess[[transformers.ViltImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opsional*) : Flag pengembang untuk input tambahan yang mirip gambar yang juga akan dipreprocess. Gunakan ini hanya jika meneruskan input sebagai kwarg tidak berhasil. Misalnya, `preprocess(images, masks=masks)` adalah pilihan yang disarankan, tetapi dapat menyebabkan masalah prioritas argumen pada beberapa model. Dalam kasus tersebut, `preprocess(images, image_like_inputs={"masks": masks})` dapat digunakan sebagai gantinya.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
Praproses sebuah gambar atau kumpulan gambar.
## ViltImageProcessorPil[[transformers.ViltImageProcessorPil]]
#### transformers.ViltImageProcessorPil[[transformers.ViltImageProcessorPil]]
```python
transformers.ViltImageProcessorPil(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/image_processing_pil_vilt.py#L113)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'shortest_edge' : 384}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `3`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
Mengembalikan tensor bertumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor. --
Membangun pemroses gambar ViltImageProcessor.
disable_grouping (`bool`, *kwargs*, *opsional*): Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan bukan dalam batch. Jika None, akan diatur ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157 image_seq_length (`int`, *kwargs*, *opsional*): Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini seharusnya diatur sebagai atribut prosesor pada model-model mendatang.
#### preprocess[[transformers.ViltImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opsional*) : Flag pengembang untuk input tambahan yang mirip gambar yang juga akan dipreprocess. Gunakan ini hanya jika meneruskan input sebagai kwarg tidak berhasil. Misalnya, `preprocess(images, masks=masks)` adalah pilihan yang disarankan, tetapi dapat menyebabkan masalah prioritas argumen pada beberapa model. Dalam kasus tersebut, `preprocess(images, image_like_inputs={"masks": masks})` dapat digunakan sebagai gantinya.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
Praproses sebuah gambar atau kumpulan gambar.
## ViltProcessor[[transformers.ViltProcessor]]
#### transformers.ViltProcessor[[transformers.ViltProcessor]]
```python
transformers.ViltProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/processing_vilt.py#L38)
**Parameter:**
image_processor (`ViltImageProcessor`) : Prosesor gambar adalah input yang wajib.
tokenizer (`BertTokenizer`) : Tokenizer adalah input yang wajib.
Membangun ViltProcessor yang membungkus image processor dan tokenizer menjadi satu processor.
[ViltProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltProcessor) menyediakan semua fungsionalitas dari [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor) dan [BertTokenizer](/docs/transformers/main/id/model_doc/lxmert#transformers.BertTokenizer). Lihat [~ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor) dan [~BertTokenizer](/docs/transformers/main/id/model_doc/lxmert#transformers.BertTokenizer) untuk informasi lebih lanjut.
#### __call__[[transformers.ViltProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opsional*) : Gambar untuk dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opsional*) : Urutan atau batch dari urutan yang akan dienkod. Setiap urutan dapat berupa string atau daftar string (string yang sudah dipretokenisasi). Jika Anda memasukkan input yang sudah dipretokenisasi, setel `is_split_into_words=True` untuk menghindari ambiguitas dengan input yang di-batch.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *opsional*) : Video yang akan dipreprocess. Mengharapkan satu video atau batch video dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan video dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *opsional*) : Audio atau batch audio yang akan disiapkan. Setiap audio dapat berupa array NumPy atau tensor PyTorch. Jika berupa array NumPy/tensor PyTorch, setiap audio harus memiliki bentuk (C, T), di mana C adalah jumlah channel, dan T adalah panjang sampel audio.
return_tensors (`str` atau [TensorType](/docs/transformers/main/id/internal/file_utils#transformers.TensorType), *opsional*) : Jika diatur, akan mengembalikan tensor dari framework tertentu. Nilai yang dapat diterima adalah: - `'pt'`: Mengembalikan objek `torch.Tensor` PyTorch. - `'np'`: Mengembalikan objek `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/id/main_classes/processors#transformers.ProcessingKwargs), *opsional*) : Opsi pemrosesan tambahan untuk setiap modalitas (teks, gambar, video, audio). Parameter spesifik model tercantum di atas; lihat kelas TypedDict untuk daftar lengkap argumen yang didukung.
## ViltModel[[transformers.ViltModel]]
#### transformers.ViltModel[[transformers.ViltModel]]
```python
transformers.ViltModel(config: ViltConfig, add_pooling_layer = True)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L511)
**Parameter:**
config ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
add_pooling_layer (`bool`, *opsional*, defaultnya `True`) : Apakah akan menambahkan lapisan pooling
Model Vilt polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.ViltModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L535)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token segmen untuk menunjukkan bagian pertama dan kedua dari input. Indeks dipilih dalam `[0, 1]`: - 0 sesuai dengan token *sentence A*, - 1 sesuai dengan token *sentence B*. [Apa itu token type IDs?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor). Lihat [ViltImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([ViltProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltProcessor) menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor) untuk memproses gambar).
pixel_mask (`torch.LongTensor` dengan bentuk `(batch_size, height, width)`, *opsional*) : Mask untuk menghindari pelaksanaan perhatian pada nilai piksel padding. Nilai mask yang dipilih dalam `[0, 1]`: - 1 untuk piksel yang asli (yaitu **tidak dimask**), - 0 untuk piksel yang merupakan padding (yaitu **dimask**). [Apa itu attention mask?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
image_embeds (`torch.Tensor` dengan bentuk `(batch_size, num_patches, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `pixel_values`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi `pixel_values` menjadi patch embeddings.
image_token_type_idx (`int`, *opsional*) : - ID tipe token untuk gambar.
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/main/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) dan input.
Metode forward dari [ViltModel](/docs/transformers/main/id/model_doc/vilt#transformers.ViltModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import ViltProcessor, ViltModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltModel.from_pretrained("dandelin/vilt-b32-mlm")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViltForMaskedLM[[transformers.ViltForMaskedLM]]
#### transformers.ViltForMaskedLM[[transformers.ViltForMaskedLM]]
```python
transformers.ViltForMaskedLM(config: ViltConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L671)
**Parameter:**
config ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model ViLT dengan kepala pemodelan bahasa di atasnya, seperti yang dilakukan selama pra-pelatihan.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.ViltForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L692)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token segmen untuk menunjukkan bagian pertama dan kedua dari input. Indeks dipilih dalam `[0, 1]`: - 0 sesuai dengan token *sentence A*, - 1 sesuai dengan token *sentence B*. [Apa itu token type IDs?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor). Lihat [ViltImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([ViltProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltProcessor) menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor) untuk memproses gambar).
pixel_mask (`torch.LongTensor` dengan bentuk `(batch_size, height, width)`, *opsional*) : Mask untuk menghindari pelaksanaan perhatian pada nilai piksel padding. Nilai mask yang dipilih dalam `[0, 1]`: - 1 untuk piksel yang asli (yaitu **tidak dimask**), - 0 untuk piksel yang merupakan padding (yaitu **dimask**). [Apa itu attention mask?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
image_embeds (`torch.Tensor` dengan bentuk `(batch_size, num_patches, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `pixel_values`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi `pixel_values` menjadi patch embeddings.
labels (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Label untuk menghitung kerugian pemodelan bahasa yang disamarkan. Indeks harus berada dalam `[-100, 0, ..., config.vocab_size]` (lihat docstring `input_ids`) Token dengan indeks yang diset ke `-100` diabaikan (disamarkan), kerugian hanya dihitung untuk token dengan label dalam `[0, ..., config.vocab_size]`.
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/main/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
**Mengembalikan:** [MaskedLMOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) atau `tuple(torch.Tensor)`
A [MaskedLMOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) dan input.
Metode forward [ViltForMaskedLM](/docs/transformers/main/id/model_doc/vilt#transformers.ViltForMaskedLM) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `labels` diberikan) -- Masked language modeling (MLM) loss.
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, config.vocab_size)`) -- Skor prediksi dari kepala pemodelan bahasa (skor untuk setiap token kosakata sebelum SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import ViltProcessor, ViltForMaskedLM
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import re
>>> import torch
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a bunch of [MASK] laying on a [MASK]."
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltForMaskedLM.from_pretrained("dandelin/vilt-b32-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> tl = len(re.findall("\[MASK\]", text))
>>> inferred_token = [text]
>>> # gradually fill in the MASK tokens, one by one
>>> with torch.no_grad():
... for i in range(tl):
... encoded = processor.tokenizer(inferred_token)
... input_ids = torch.tensor(encoded.input_ids)
... encoded = encoded["input_ids"][0][1:-1]
... outputs = model(input_ids=input_ids, pixel_values=encoding.pixel_values)
... mlm_logits = outputs.logits[0] # shape (seq_len, vocab_size)
... # only take into account text features (minus CLS and SEP token)
... mlm_logits = mlm_logits[1 : input_ids.shape[1] - 1, :]
... mlm_values, mlm_ids = mlm_logits.softmax(dim=-1).max(dim=-1)
... # only take into account text
... mlm_values[torch.tensor(encoded) != 103] = 0
... select = mlm_values.argmax().item()
... encoded[select] = mlm_ids[select].item()
... inferred_token = [processor.decode(encoded)]
>>> selected_token = ""
>>> encoded = processor.tokenizer(inferred_token)
>>> output = processor.decode(encoded.input_ids[0], skip_special_tokens=True)
>>> print(output)
a bunch of cats laying on a couch.
```
## ViltForQuestionAnswering[[transformers.ViltForQuestionAnswering]]
#### transformers.ViltForQuestionAnswering[[transformers.ViltForQuestionAnswering]]
```python
transformers.ViltForQuestionAnswering(config: ViltConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L840)
**Parameter:**
config ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model transformer Vilt dengan kepala klasifikasi di atasnya (lapisan linear di atas keadaan tersembunyi akhir dari token [CLS]) untuk menjawab pertanyaan visual, misalnya untuk VQAv2.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.ViltForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L858)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token segmen untuk menunjukkan bagian pertama dan kedua dari input. Indeks dipilih dalam `[0, 1]`: - 0 sesuai dengan token *sentence A*, - 1 sesuai dengan token *sentence B*. [Apa itu token type IDs?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor). Lihat [ViltImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([ViltProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltProcessor) menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor) untuk memproses gambar).
pixel_mask (`torch.LongTensor` dengan bentuk `(batch_size, height, width)`, *opsional*) : Mask untuk menghindari pelaksanaan perhatian pada nilai piksel padding. Nilai mask yang dipilih dalam `[0, 1]`: - 1 untuk piksel yang asli (yaitu **tidak dimask**), - 0 untuk piksel yang merupakan padding (yaitu **dimask**). [Apa itu attention mask?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
image_embeds (`torch.Tensor` dengan bentuk `(batch_size, num_patches, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `pixel_values`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi `pixel_values` menjadi patch embeddings.
labels (`torch.Tensor` dengan bentuk `(batch_size, num_labels)`, *opsional*) : Label untuk menghitung loss visual question answering. Tensor ini harus berupa one-hot encoding dari semua jawaban yang berlaku untuk contoh tertentu dalam batch, atau soft encoding yang menunjukkan jawaban mana yang berlaku, di mana 1.0 adalah skor tertinggi.
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/main/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
**Mengembalikan:** [SequenceClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) atau `tuple(torch.Tensor)`
[SequenceClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) dan input.
Metode forward dari [ViltForQuestionAnswering](/docs/transformers/main/id/model_doc/vilt#transformers.ViltForQuestionAnswering) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan saat `labels` disediakan) -- Loss klasifikasi (atau regresi jika config.num_labels==1).
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, config.num_labels)`) -- Skor klasifikasi (atau regresi jika config.num_labels==1) (sebelum SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import ViltProcessor, ViltForQuestionAnswering
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "How many cats are there?"
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
>>> model = ViltForQuestionAnswering.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> logits = outputs.logits
>>> idx = logits.argmax(-1).item()
>>> print("Predicted answer:", model.config.id2label[idx])
Predicted answer: 2
```
## ViltForImagesAndTextClassification[[transformers.ViltForImagesAndTextClassification]]
#### transformers.ViltForImagesAndTextClassification[[transformers.ViltForImagesAndTextClassification]]
```python
transformers.ViltForImagesAndTextClassification(config: ViltConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L1052)
**Parameter:**
config ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model transformer Vilt dengan kepala klasifikasi di atasnya untuk penalaran visual bahasa alami, misalnya NLVR2.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.ViltForImagesAndTextClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L1071)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token segmen untuk menunjukkan bagian pertama dan kedua dari input. Indeks dipilih dalam `[0, 1]`: - 0 sesuai dengan token *sentence A*, - 1 sesuai dengan token *sentence B*. [Apa itu token type IDs?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor). Lihat [ViltImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([ViltProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltProcessor) menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor) untuk memproses gambar).
pixel_mask (`torch.LongTensor` dengan bentuk `(batch_size, height, width)`, *opsional*) : Mask untuk menghindari pelaksanaan perhatian pada nilai piksel padding. Nilai mask yang dipilih dalam `[0, 1]`: - 1 untuk piksel yang asli (yaitu **tidak dimask**), - 0 untuk piksel yang merupakan padding (yaitu **dimask**). [Apa itu attention mask?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
image_embeds (`torch.Tensor` dengan bentuk `(batch_size, num_patches, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `pixel_values`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi `pixel_values` menjadi patch embeddings.
labels (`torch.LongTensor` dengan bentuk `(batch_size,)`, *opsional*) : Label klasifikasi biner.
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/main/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
**Mengembalikan:** `ViltForImagesAndTextClassificationOutput` atau `tuple(torch.Tensor)`
Sebuah `ViltForImagesAndTextClassificationOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) dan input.
Metode forward [ViltForImagesAndTextClassification](/docs/transformers/main/id/model_doc/vilt#transformers.ViltForImagesAndTextClassification) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan saat `labels` disediakan) -- Loss klasifikasi (atau regresi jika config.num_labels==1).
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, config.num_labels)`) -- Skor klasifikasi (atau regresi jika config.num_labels==1) (sebelum SoftMax).
- **hidden_states** (`list[tuple(torch.Tensor)]`, *opsional*, dikembalikan ketika `output_hidden_states=True` dilewatkan atau ketika `config.output_hidden_states=True`) -- Daftar tuple `torch.Tensor` (satu untuk setiap pasangan gambar-teks, di mana setiap tuple berisi output dari embeddings + satu untuk output dari setiap layer) dengan bentuk `(batch_size, sequence_length, hidden_size)`. Hidden-states model pada output dari setiap layer ditambah output embeddings awal.
- **attentions** (`list[tuple[torch.Tensor]]`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import ViltProcessor, ViltForImagesAndTextClassification
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url_1 = "https://lil.nlp.cornell.edu/nlvr/exs/ex0_0.jpg"
>>> with httpx.stream("GET", url_1) as response:
... image_1 = Image.open(BytesIO(response.read()))
>>> url_2 = "https://lil.nlp.cornell.edu/nlvr/exs/ex0_1.jpg"
>>> with httpx.stream("GET", url_2) as response:
... image_2 = Image.open(BytesIO(response.read()))
>>> text = "The left image contains twice the number of dogs as the right image."
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-nlvr2")
>>> model = ViltForImagesAndTextClassification.from_pretrained("dandelin/vilt-b32-finetuned-nlvr2")
>>> # prepare inputs
>>> encoding = processor([image_1, image_2], text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(input_ids=encoding.input_ids, pixel_values=encoding.pixel_values.unsqueeze(0))
>>> logits = outputs.logits
>>> idx = logits.argmax(-1).item()
>>> print("Predicted answer:", model.config.id2label[idx])
Predicted answer: True
```
## ViltForImageAndTextRetrieval[[transformers.ViltForImageAndTextRetrieval]]
#### transformers.ViltForImageAndTextRetrieval[[transformers.ViltForImageAndTextRetrieval]]
```python
transformers.ViltForImageAndTextRetrieval(config: ViltConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L953)
**Parameter:**
config ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model transformer Vilt dengan kepala klasifikasi di atasnya (lapisan linear di atas keadaan tersembunyi akhir dari token [CLS]) untuk pengambilan gambar-ke-teks atau teks-ke-gambar, misalnya MSCOCO dan F30K.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.ViltForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L965)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token segmen untuk menunjukkan bagian pertama dan kedua dari input. Indeks dipilih dalam `[0, 1]`: - 0 sesuai dengan token *sentence A*, - 1 sesuai dengan token *sentence B*. [Apa itu token type IDs?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor). Lihat [ViltImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([ViltProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltProcessor) menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor) untuk memproses gambar).
pixel_mask (`torch.LongTensor` dengan bentuk `(batch_size, height, width)`, *opsional*) : Mask untuk menghindari pelaksanaan perhatian pada nilai piksel padding. Nilai mask yang dipilih dalam `[0, 1]`: - 1 untuk piksel yang asli (yaitu **tidak dimask**), - 0 untuk piksel yang merupakan padding (yaitu **dimask**). [Apa itu attention mask?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
image_embeds (`torch.Tensor` dengan bentuk `(batch_size, num_patches, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `pixel_values`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi `pixel_values` menjadi patch embeddings.
labels (`torch.LongTensor` dengan bentuk `(batch_size,)`, *opsional*) : Label saat ini tidak didukung.
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/main/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
**Mengembalikan:** [SequenceClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) atau `tuple(torch.Tensor)`
[SequenceClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) dan input.
Metode forward [ViltForImageAndTextRetrieval](/docs/transformers/main/id/model_doc/vilt#transformers.ViltForImageAndTextRetrieval) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan saat `labels` disediakan) -- Loss klasifikasi (atau regresi jika config.num_labels==1).
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, config.num_labels)`) -- Skor klasifikasi (atau regresi jika config.num_labels==1) (sebelum SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import ViltProcessor, ViltForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-coco")
>>> model = ViltForImageAndTextRetrieval.from_pretrained("dandelin/vilt-b32-finetuned-coco")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, :].item()
```
## ViltForTokenClassification[[transformers.ViltForTokenClassification]]
#### transformers.ViltForTokenClassification[[transformers.ViltForTokenClassification]]
```python
transformers.ViltForTokenClassification(config: ViltConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L1194)
**Parameter:**
config ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Transformer Vilt dengan kepala klasifikasi token di atasnya (lapisan linear di atas keluaran hidden-states), misalnya untuk tugas Named-Entity-Recognition (NER).
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.ViltForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L1207)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token segmen untuk menunjukkan bagian pertama dan kedua dari input. Indeks dipilih dalam `[0, 1]`: - 0 sesuai dengan token *sentence A*, - 1 sesuai dengan token *sentence B*. [Apa itu token type IDs?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor). Lihat [ViltImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([ViltProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltProcessor) menggunakan [ViltImageProcessor](/docs/transformers/main/id/model_doc/vilt#transformers.ViltImageProcessor) untuk memproses gambar).
pixel_mask (`torch.LongTensor` dengan bentuk `(batch_size, height, width)`, *opsional*) : Mask untuk menghindari pelaksanaan perhatian pada nilai piksel padding. Nilai mask yang dipilih dalam `[0, 1]`: - 1 untuk piksel yang asli (yaitu **tidak dimask**), - 0 untuk piksel yang merupakan padding (yaitu **dimask**). [Apa itu attention mask?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
image_embeds (`torch.Tensor` dengan bentuk `(batch_size, num_patches, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `pixel_values`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi `pixel_values` menjadi patch embeddings.
labels (`torch.LongTensor` dengan bentuk `(batch_size, text_sequence_length)`, *opsional*) : Label untuk menghitung kerugian klasifikasi token. Indeks harus berada dalam `[0, ..., config.num_labels - 1]`.
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/main/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
**Mengembalikan:** [TokenClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) atau `tuple(torch.Tensor)`
[TokenClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([ViltConfig](/docs/transformers/main/id/model_doc/vilt#transformers.ViltConfig)) dan input.
Metode forward dari [ViltForTokenClassification](/docs/transformers/main/id/model_doc/vilt#transformers.ViltForTokenClassification) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `labels` disediakan) -- Loss klasifikasi.
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, config.num_labels)`) -- Skor klasifikasi (sebelum SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoTokenizer, ViltForTokenClassification
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltForTokenClassification.from_pretrained("dandelin/vilt-b32-mlm")
>>> inputs = tokenizer(
... "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_token_class_ids = logits.argmax(-1)
>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...
>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```