# ViTMatte
## Ikhtisar
Model ViTMatte diusulkan dalam [Boosting Image Matting with Pretrained Plain Vision Transformers](https://huggingface.co/papers/2305.15272) oleh Jingfeng Yao, Xinggang Wang, Shusheng Yang, Baoyuan Wang. ViTMatte memanfaatkan [Vision Transformers](vit) polos untuk tugas image matting, yaitu proses memperkirakan objek latar depan dalam gambar dan video secara akurat.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Baru-baru ini, vision Transformer (ViT) polos telah menunjukkan kinerja yang mengesankan pada berbagai tugas computer vision, berkat kapasitas pemodelan yang kuat dan pretraining berskala besar. Namun, ViT belum menaklukkan masalah image matting. Kami menghipotesiskan bahwa image matting juga dapat ditingkatkan dengan ViT, dan kami memperkenalkan sistem matting berbasis ViT yang baru, efisien, dan robust, yang bernama ViTMatte. Metode kami memanfaatkan (i) mekanisme attention hibrida yang dikombinasikan dengan convolution neck untuk membantu ViT mencapai trade-off kinerja-komputasi yang sangat baik pada tugas matting. (ii) Selain itu, kami memperkenalkan modul detail capture, yang hanya terdiri dari convolution ringan sederhana untuk melengkapi informasi detail yang dibutuhkan oleh matting. Sejauh pengetahuan kami, ViTMatte adalah karya pertama yang melepaskan potensi ViT pada image matting dengan adaptasi yang ringkas. ViTMatte mewarisi banyak sifat unggul dari ViT ke matting, termasuk berbagai strategi pretraining, desain arsitektur yang ringkas, dan strategi inferensi yang fleksibel. Kami mengevaluasi ViTMatte pada Composition-1k dan Distinctions-646, benchmark yang paling umum digunakan untuk image matting; metode kami mencapai kinerja state-of-the-art dan melampaui karya matting sebelumnya dengan selisih yang besar.*
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/hustvl/ViTMatte).
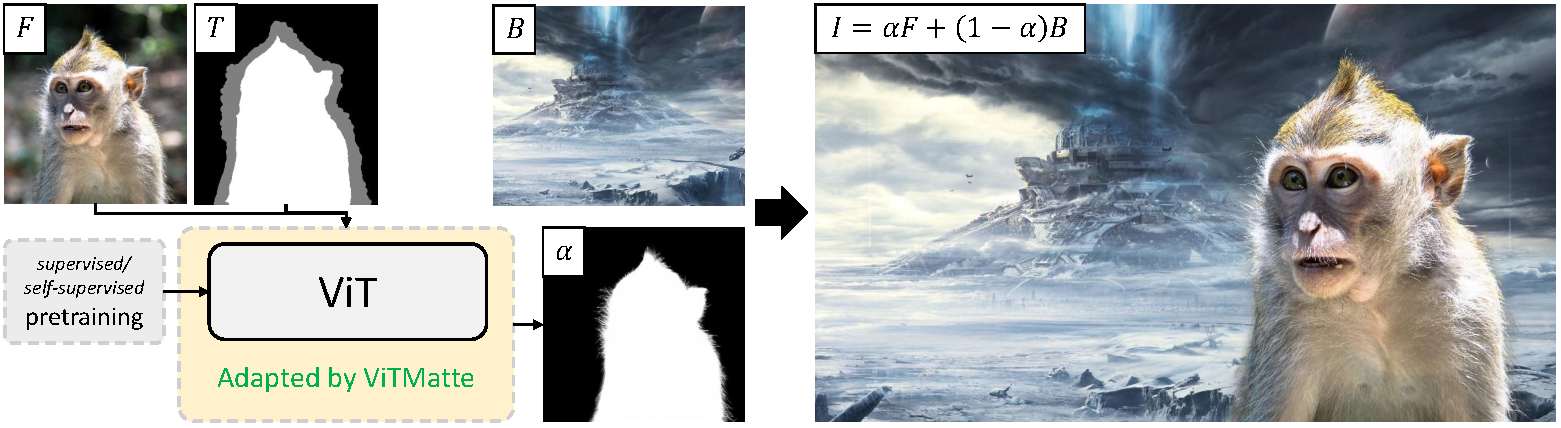 Ikhtisar tingkat tinggi ViTMatte. Diambil dari makalah aslinya.
## Sumber daya
Daftar sumber resmi Hugging Face dan komunitas (ditandai dengan 🌎) untuk membantu Anda memulai dengan ViTMatte.
- Notebook demo mengenai inferensi dengan [VitMatteForImageMatting](/docs/transformers/main/id/model_doc/vitmatte#transformers.VitMatteForImageMatting), termasuk penggantian latar belakang, dapat ditemukan [di sini](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ViTMatte).
Model mengharapkan baik gambar maupun trimap (yang digabungkan) sebagai input. Gunakan `ViTMatteImageProcessor` untuk tujuan ini.
## VitMatteConfig[[transformers.VitMatteConfig]]
#### transformers.VitMatteConfig[[transformers.VitMatteConfig]]
```python
transformers.VitMatteConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, hidden_size: int = 384, batch_norm_eps: float = 1e-05, initializer_range: float = 0.02, convstream_hidden_sizes: list[int] | tuple[int, ...] = (48, 96, 192), fusion_hidden_sizes: list[int] | tuple[int, ...] = (256, 128, 64, 32))
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/configuration_vitmatte.py#L25)
**Parameter:**
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Konfigurasi dari model backbone.
hidden_size (`int`, *opsional*, defaultnya `384`) : Dimensi dari representasi tersembunyi.
batch_norm_eps (`float`, *opsional*, default 1e-05) : Epsilon yang digunakan oleh lapisan batch norm.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
convstream_hidden_sizes (`list[int]`, *opsional*, defaultnya `[48, 96, 192]`) : Kanal output dari modul ConvStream.
fusion_hidden_sizes (`list[int]`, *opsional*, defaultnya `[256, 128, 64, 32]`) : Kanal output dari blok Fusion.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari VitmatteModel. Kelas ini digunakan untuk membuat instans model Vitmatte sesuai dengan argumen yang ditentukan, yang mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [hustvl/vitmatte-small-composition-1k](https://huggingface.co/hustvl/vitmatte-small-composition-1k)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import VitMatteConfig, VitMatteForImageMatting
>>> # Initializing a ViTMatte hustvl/vitmatte-small-composition-1k style configuration
>>> configuration = VitMatteConfig()
>>> # Initializing a model (with random weights) from the hustvl/vitmatte-small-composition-1k style configuration
>>> model = VitMatteForImageMatting(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## VitMatteImageProcessor[[transformers.VitMatteImageProcessor]]
#### transformers.VitMatteImageProcessor[[transformers.VitMatteImageProcessor]]
```python
transformers.VitMatteImageProcessor(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_vitmatte.py#L45)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
size_divisor (`int`, *kwargs*, *opsional*, defaultnya `self.size_divisor`) : Lebar dan tinggi gambar akan di-*pad* agar dapat dibagi habis oleh angka ini.
Membangun pemroses gambar VitMatteImageProcessor.
#### preprocess[[transformers.VitMatteImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], trimaps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_vitmatte.py#L87)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
trimaps (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : trimaps yang akan dipreprocess.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
size_divisor (`int`, *kwargs*, *opsional*, defaultnya `self.size_divisor`) : Lebar dan tinggi gambar akan di-*pad* agar dapat dibagi habis oleh angka ini.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## VitMatteImageProcessorPil[[transformers.VitMatteImageProcessorPil]]
#### transformers.VitMatteImageProcessorPil[[transformers.VitMatteImageProcessorPil]]
```python
transformers.VitMatteImageProcessorPil(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_pil_vitmatte.py#L44)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
size_divisor (`int`, *kwargs*, *opsional*, defaultnya `self.size_divisor`) : Lebar dan tinggi gambar akan di-*pad* agar dapat dibagi habis oleh angka ini.
Membangun pemroses gambar VitMatteImageProcessor.
#### preprocess[[transformers.VitMatteImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], trimaps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_pil_vitmatte.py#L89)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
trimaps (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : trimaps yang akan dipreprocess.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
size_divisor (`int`, *kwargs*, *opsional*, defaultnya `self.size_divisor`) : Lebar dan tinggi gambar akan di-*pad* agar dapat dibagi habis oleh angka ini.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## VitMatteForImageMatting[[transformers.VitMatteForImageMatting]]
#### transformers.VitMatteForImageMatting[[transformers.VitMatteForImageMatting]]
```python
transformers.VitMatteForImageMatting(config: VitMatteConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/modeling_vitmatte.py#L221)
**Parameter:**
config ([VitMatteConfig](/docs/transformers/main/id/model_doc/vitmatte#transformers.VitMatteConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Framework ViTMatte yang memanfaatkan backbone visi apa pun, misalnya untuk ADE20k, CityScapes.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.VitMatteForImageMatting.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/modeling_vitmatte.py#L232)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [VitMatteImageProcessor](/docs/transformers/main/id/model_doc/vitmatte#transformers.VitMatteImageProcessor). Lihat [VitMatteImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [VitMatteImageProcessor](/docs/transformers/main/id/model_doc/vitmatte#transformers.VitMatteImageProcessor) untuk memproses gambar).
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
labels (`torch.LongTensor` dengan bentuk `(batch_size, height, width)`, *opsional*) : Gambar matting ground truth untuk menghitung loss.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/main/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
Metode forward dari [VitMatteForImageMatting](/docs/transformers/main/id/model_doc/vitmatte#transformers.VitMatteForImageMatting) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
Contoh:
```python
>>> from transformers import VitMatteImageProcessor, VitMatteForImageMatting
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download
>>> processor = VitMatteImageProcessor.from_pretrained("hustvl/vitmatte-small-composition-1k")
>>> model = VitMatteForImageMatting.from_pretrained("hustvl/vitmatte-small-composition-1k")
>>> filepath = hf_hub_download(
... repo_id="hf-internal-testing/image-matting-fixtures", filename="image.png", repo_type="dataset"
... )
>>> image = Image.open(filepath).convert("RGB")
>>> filepath = hf_hub_download(
... repo_id="hf-internal-testing/image-matting-fixtures", filename="trimap.png", repo_type="dataset"
... )
>>> trimap = Image.open(filepath).convert("L")
>>> # prepare image + trimap for the model
>>> inputs = processor(images=image, trimaps=trimap, return_tensors="pt")
>>> with torch.no_grad():
... alphas = model(**inputs).alphas
>>> print(alphas.shape)
torch.Size([1, 1, 640, 960])
```