# BLIP-2
## 개요
BLIP-2 모델은 Junnan Li, Dongxu Li, Silvio Savarese, Steven Hoi가 [BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models](https://huggingface.co/papers/2301.12597)에서 제안했습니다. BLIP-2는 동결된 사전 학습된 이미지 인코더와 대규모 언어 모델(LLM)을 활용하며, 이 둘 사이에 경량화된 12층 Transformer 인코더를 학습시켜 다양한 비전-언어 작업에서 최첨단 성능을 달성합니다. 특히, BLIP-2는 800억 개 매개변수를 가진 [Flamingo](https://huggingface.co/papers/2204.14198) 모델보다 학습 가능한 매개변수가 54배 적은 상태에서 zero-shot VQAv2에서 8.7%의 성능 향상을 보입니다.
해당 논문의 초록은 다음과 같습니다:
*대규모 모델의 end-to-end 학습으로 인해 vision-and-language pre-training의 비용이 점점 더 감당하기 어려워지고 있습니다. 본 논문에서는 BLIP-2를 제안합니다. BLIP-2는 범용적이고 효율적인 pre-training 전략으로, 기존에 제공되는 frozen pre-trained image encoder와 frozen large language model을 활용하여 vision-language pre-training을 bootstrap합니다. BLIP-2는 lightweight Querying Transformer를 통해 modality gap를 연결하며, 이 Querying Transformer는 두 단계로 pre-training됩니다. 첫 번째 단계에서는 frozen image encoder로부터 vision-language representation learning을 bootstrap합니다. 두 번째 단계에서는 frozen language model로부터 vision-to-language generative learning을 bootstrap합니다. BLIP-2는 기존 방법보다 학습 가능한 파라미터 수가 현저히 적음에도 불구하고, 다양한 vision-language task에서 state-of-the-art 성능을 달성합니다. 예를 들어, 우리의 모델은 학습 가능한 파라미터 수가 54배 적은 상태에서 zero-shot VQAv2에서 Flamingo80B보다 8.7% 높은 성능을 보입니다. 또한, 자연어 지시를 따를 수 있는 zero-shot image-to-text generation의 신흥 능력을 시연합니다.*
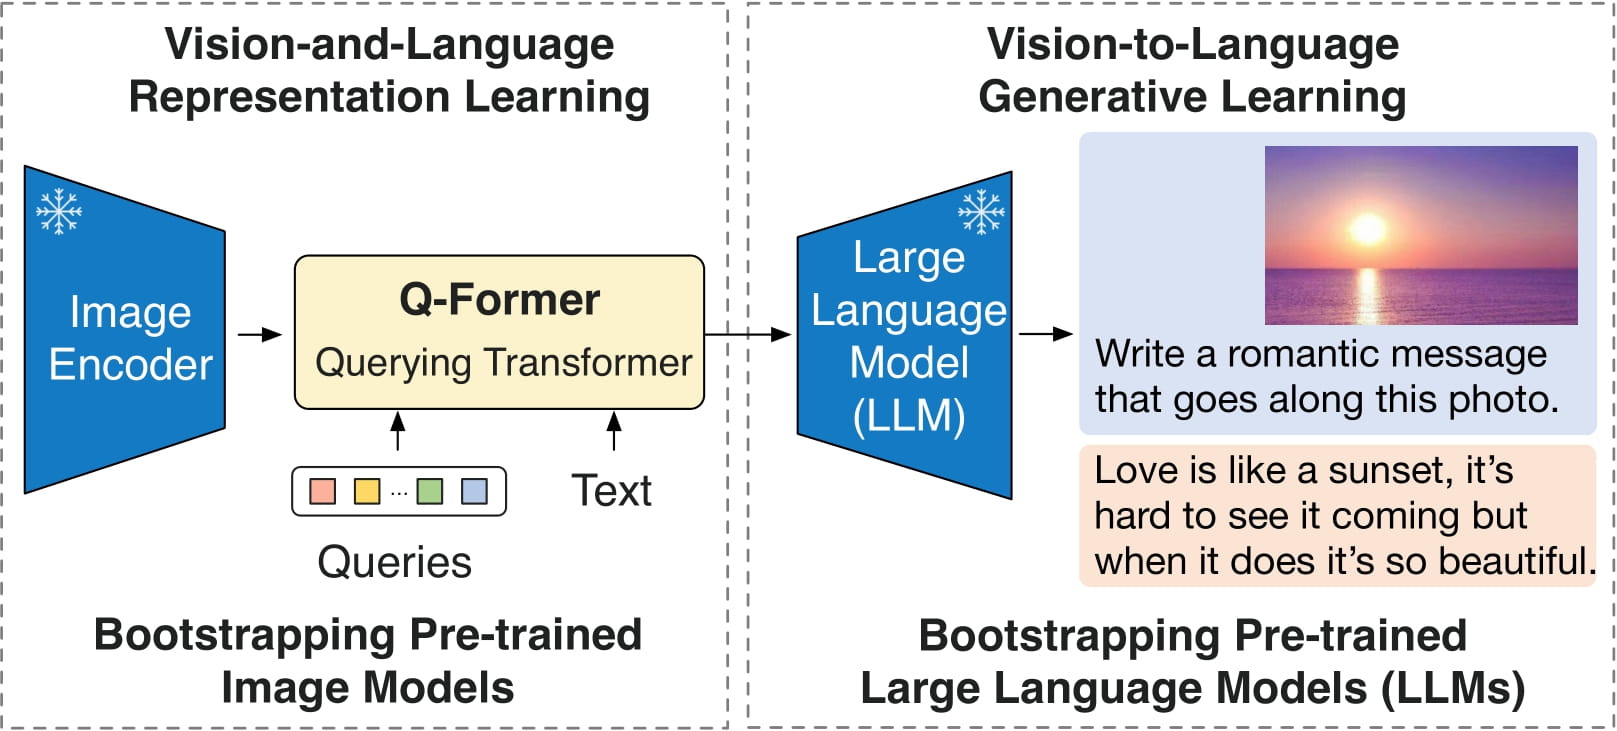 BLIP-2 아키텍처. 원 논문에서 가져왔습니다.
이 모델은 [nielsr](https://huggingface.co/nielsr)에 의해 기여되었습니다. 원본 코드는 [여기](https://github.com/salesforce/LAVIS/tree/5ee63d688ba4cebff63acee04adaef2dee9af207)에서 찾을 수 있습니다.
## 사용 팁
- BLIP-2는 이미지와 선택적 텍스트 프롬프트를 조건으로 텍스트 생성에 사용할 수 있습니다. 추론 시에는 `generate` 메서드를 사용하는 것이 권장됩니다.
- [Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)를 사용하여 이미지를 모델에 맞게 준비하고, 예측된 토큰 ID를 다시 텍스트로 디코딩할 수 있습니다.
> [!NOTE]
> v4.46 릴리스 이후의 BLIP 모델은 `processor.num_query_tokens = {{num_query_tokens}}`를 추가하고 모델 임베딩 레이어를 확장하여 특수 `` 토큰을 추가하는 것에 대한 경고를 발생시킵니다. 모델 체크포인트를 소유하고 있다면 프로세서에 해당 속성을 추가하는 것이 강력히 권장되며, 소유자가 아니라면 PR을 열어 주세요. 이러한 속성을 추가하면 BLIP는 이미지당 필요한 쿼리 토큰 수를 추가하고, 쿼리 토큰 수만큼 `` 플레이스홀더로 텍스트를 확장합니다. 일반적으로 이미지당 약 500개의 토큰이 필요하므로, 텍스트가 잘리지 않도록 확인해야 합니다. 그렇지 않으면 임베딩 병합 시 실패가 발생합니다.
속성은 모델 구성에서 `model.config.num_query_tokens`와 같이 가져올 수 있으며, 모델 임베딩 확장은 [이 링크](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042)를 참고하여 수행할 수 있습니다.
## 리소스
BLIP-2 시작을 돕기 위한 공식 Hugging Face 및 커뮤니티(🌎로 표시) 리소스 목록입니다.
- 이미지 캡셔닝, 시각 질의응답(VQA), 대화형 대화에 대한 BLIP-2 데모 노트북은 [여기](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BLIP-2)에서 찾을 수 있습니다.
여기에 포함할 리소스를 제출하고 싶으시면 Pull Request를 열어 주시면 검토하겠습니다! 기존 리소스와 중복되지 않고 새로운 것을 보여주는 것이 이상적입니다.
## Blip2Config[[transformers.Blip2Config]]
#### transformers.Blip2Config[[transformers.Blip2Config]]
```python
transformers.Blip2Config(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, image_text_hidden_size: int = 256, image_token_index: int | None = None, initializer_factor: float = 1.0, initializer_range: float = 0.02)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/configuration_blip_2.py#L107)
**매개변수:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *선택*) : 비전 백본의 config 객체 또는 사전 정의된 config 딕셔너리입니다.
qformer_config (`dict`, *선택 사항*) : [Blip2QFormerConfig](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2QFormerConfig)를 초기화하는 데 사용되는 구성 옵션의 사전.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *선택*) : 텍스트 백본의 config 객체 또는 사전입니다.
num_query_tokens (`int`, *선택 사항*, 기본값 32) : Transformer를 통과하는 쿼리 토큰의 수입니다.
image_text_hidden_size (`int`, *선택 사항*, 기본값 256) : 이미지-텍스트 융합 레이어의 숨겨진 상태 차원.
image_token_index (`int`, *선택 사항*) : 입력 이미지의 자리표시자로 사용되는 이미지 토큰 인덱스입니다.
initializer_factor (`float`, *선택 사항*, 기본값 `1.0`) : 모든 가중치 행렬을 초기화하는 계수입니다(1로 유지해야 하며, 초기화 테스트를 위해 내부적으로 사용됨).
initializer_range (`float`, *선택 사항*, 기본값 `0.02`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
이것은 Blip 2 모델의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Blip 2 모델을 초기화하고 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 초기화하면 [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import (
... Blip2VisionConfig,
... Blip2QFormerConfig,
... OPTConfig,
... Blip2Config,
... Blip2ForConditionalGeneration,
... )
>>> # Initializing a Blip2Config with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2Config()
>>> # Initializing a Blip2ForConditionalGeneration (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2ForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a Blip2Config from a Blip2VisionConfig, Blip2QFormerConfig and any PreTrainedConfig
>>> # Initializing BLIP-2 vision, BLIP-2 Q-Former and language model configurations
>>> vision_config = Blip2VisionConfig()
>>> qformer_config = Blip2QFormerConfig()
>>> text_config = OPTConfig()
>>> config = Blip2Config(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## Blip2VisionConfig[[transformers.Blip2VisionConfig]]
#### transformers.Blip2VisionConfig[[transformers.Blip2VisionConfig]]
```python
transformers.Blip2VisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/configuration_blip_2.py#L29)
**매개변수:**
hidden_size (`int`, *선택 사항*, 기본값 `1408`) : 숨겨진 표현의 차원.
intermediate_size (`int`, *선택 사항*, 기본값 `6144`) : MLP 표현의 차원.
num_hidden_layers (`int`, *선택 사항*, 기본값 `39`) : Transformer 디코더의 숨겨진 레이어 수.
num_attention_heads (`int`, *선택 사항*, 기본값 `16`) : Transformer decoder의 각 attention layer에 사용할 attention head의 수입니다.
image_size (`Union[int, list[int], tuple[int, int]]`, *선택*, 기본값 `224`) : 각 이미지의 크기(해상도).
patch_size (`Union[int, list[int], tuple[int, int]]`, *선택*, 기본값 `14`) : 각 패치의 크기(해상도).
hidden_act (`str`, *선택 사항*, 기본값 `gelu`) : 디코더에서 사용되는 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등이 있습니다.
layer_norm_eps (`float`, *선택 사항*, 기본값 `1e-06`) : 레이어 정규화 레이어에서 사용되는 epsilon 값입니다.
attention_dropout (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : attention 확률에 적용할 dropout 비율입니다.
initializer_range (`float`, *선택 사항*, 기본값 `1e-10`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
qkv_bias (`bool`, *선택 사항*, 기본값 `True`) : 쿼리, 키, 값에 bias를 추가할지 여부.
이것은 Blip 2 모델의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Blip 2 모델을 초기화하고 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 초기화하면 [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import Blip2VisionConfig, Blip2VisionModel
>>> # Initializing a Blip2VisionConfig with Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2VisionConfig()
>>> # Initializing a Blip2VisionModel (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2VisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
#### transformers.Blip2QFormerConfig[[transformers.Blip2QFormerConfig]]
```python
transformers.Blip2QFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408, use_qformer_text_input: bool = False)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/configuration_blip_2.py#L64)
**매개변수:**
vocab_size (`int`, *선택 사항*, 기본값 `30522`) : 모델의 어휘 크기입니다. `input_ids`로 표현할 수 있는 서로 다른 토큰의 수를 정의합니다.
hidden_size (`int`, *선택 사항*, 기본값 `768`) : 숨겨진 표현의 차원.
num_hidden_layers (`int`, *선택 사항*, 기본값 `12`) : Transformer decoder의 숨겨진 레이어 수입니다.
num_attention_heads (`int`, *선택 사항*, 기본값 `12`) : Transformer decoder의 각 attention layer에 사용되는 attention head의 수입니다.
intermediate_size (`int`, *선택 사항*, 기본값 `3072`) : MLP 표현의 차원.
hidden_act (`str`, *선택 사항*, 기본값 `gelu`) : 디코더에서 사용되는 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등이 있습니다.
hidden_dropout_prob (`Union[float, int]`, *선택 사항*, 기본값 `0.1`) : 임베딩, 인코더, 풀러의 모든 완전 연결 계층에 적용되는 dropout 확률입니다.
attention_probs_dropout_prob (`Union[float, int]`, *선택 사항*, 기본값 `0.1`) : attention 확률에 적용할 dropout 비율입니다.
max_position_embeddings (`int`, *선택 사항*, 기본값 `512`) : 이 모델이 사용될 수 있는 최대 시퀀스 길이입니다.
initializer_range (`float`, *선택 사항*, 기본값 `0.02`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
layer_norm_eps (`float`, *선택 사항*, 기본값 `1e-12`) : layer normalization 레이어에서 사용되는 epsilon 값입니다.
pad_token_id (`int`, *선택 사항*, 기본값 `0`) : 어휘에서 패딩에 사용되는 토큰 ID입니다.
cross_attention_frequency (`int`, *선택 사항*, 기본값 2) : Transformer 레이어에 cross-attention을 추가하는 주기입니다.
encoder_hidden_size (`int`, *선택 사항*, 기본값 `1408`) : 숨겨진 표현의 차원.
use_qformer_text_input (`bool`, *선택 사항*, 기본값 `False`) : BERT 스타일 임베딩을 사용할지 여부.
이것은 Blip 2 모델의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Blip 2 모델을 초기화하고 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 초기화하면 [Salesforce/blip2-opt-2.7b](https://huggingface.co/Salesforce/blip2-opt-2.7b)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import Blip2QFormerConfig, Blip2QFormerModel
>>> # Initializing a BLIP-2 Salesforce/blip2-opt-2.7b style configuration
>>> configuration = Blip2QFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/blip2-opt-2.7b style configuration
>>> model = Blip2QFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Blip2Processor[[transformers.Blip2Processor]]
#### transformers.Blip2Processor[[transformers.Blip2Processor]]
```python
transformers.Blip2Processor(image_processor, tokenizer, num_query_tokens = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/processing_blip_2.py#L45)
**매개변수:**
image_processor (`BlipImageProcessor`) : 이미지 프로세서가 필수 입력입니다.
tokenizer (`GPT2Tokenizer`) : 토크나이저는 필수 입력입니다.
num_query_tokens (`int`, *선택 사항*) : Qformer가 쿼리로 사용하는 토큰 수이며, 모델 설정과 동일해야 합니다.
이미지 프로세서와 토크나이저를 단일 프로세서로 감싸는 Blip2Processor를 생성합니다.
[Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)는 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)와 [GPT2Tokenizer](/docs/transformers/main/ko/model_doc/gpt2#transformers.GPT2Tokenizer)의 모든 기능을 제공합니다. 자세한 내용은 [~BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)와 [~GPT2Tokenizer](/docs/transformers/main/ko/model_doc/gpt2#transformers.GPT2Tokenizer)를 참고하세요.
#### __call__[[transformers.Blip2Processor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | None = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/processing_blip_2.py#L61)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *선택*) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
text (`Union[str, list[str]]`, *선택*) : 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 사전 토큰화된 입력을 전달하는 경우, 배치 입력과의 모호성을 피하기 위해 `is_split_into_words=True`를 설정하세요.
return_tensors (`str` 또는 [TensorType](/docs/transformers/main/ko/internal/file_utils#transformers.TensorType), *optional*) : 설정된 경우, 특정 프레임워크의 텐서를 반환합니다. 허용되는 값은 다음과 같습니다: - `'pt'`: PyTorch `torch.Tensor` 객체를 반환합니다. - `'np'`: NumPy `np.ndarray` 객체를 반환합니다.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/ko/main_classes/processors#transformers.ProcessingKwargs), *optional*) : 각 모달리티(텍스트, 이미지, 비디오, 오디오)에 대한 추가 처리 옵션입니다. 모델별 매개변수는 위에 나열되어 있으며, 지원되는 인수의 전체 목록은 TypedDict 클래스를 참조하세요.
**반환값:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *선택 사항*) -- `__call__`/`encode_plus`/`batch_encode_plus` 메서드가 반환하는 리스트/배열/텐서 딕셔너리('input_ids', 'attention_mask' 등).
- **encoding** (`tokenizers.Encoding` 또는 `Sequence[tokenizers.Encoding]`, *선택 사항*) -- 토크나이저가 워드/문자 공간에서 토큰 공간으로의 매핑과 같은 추가 정보를 출력하는 fast tokenizer인 경우, `tokenizers.Encoding` 인스턴스 또는 인스턴스 목록(배치의 경우)에 이 정보가 저장됩니다.
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
- **prepend_batch_axis** (`bool`, *선택 사항*, 기본값 `False`) -- 텐서로 변환할 때 배치 축을 추가할지 여부(위에서 설명한 `tensor_type` 참조). `tensor_type` 매개변수가 설정된 경우에만 이 매개변수가 효과를 가지며, *그렇지 않으면 효과가 없습니다*.
- **n_sequences** (`int`, *선택 사항*) -- 각 인코딩이 나타내는 입력 시퀀스의 수 (`None`은 미지, `1`은 단일 시퀀스, `2`는 시퀀스 쌍을 의미합니다).
## Blip2VisionModel[[transformers.Blip2VisionModel]]
#### transformers.Blip2VisionModel[[transformers.Blip2VisionModel]]
```python
transformers.Blip2VisionModel(config: Blip2VisionConfig)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L481)
**매개변수:**
config ([Blip2VisionConfig](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2VisionConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
특정 헤드가 위에 없는 상태에서 원시 hidden-states를 출력하는 순수 Blip 2 Model입니다.
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.Blip2VisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L501)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`, *선택 사항*) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [BlipImageProcessor.__call__()](/docs/transformers/main/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)는 이미지 처리에 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용합니다).
interpolate_pos_encoding (`bool`, *선택 사항*, 기본값 `False`) : 사전 학습된 위치 인코딩을 보간할지 여부.
**반환값:** [BaseModelOutputWithPooling](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 또는 `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 또는 `torch.Tensor`의 튜플(`return_dict=False`이 전달되거나 `config.return_dict=False`인 경우)로, 구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) 및 입력에 따라 다양한 요소를 포함합니다.
[Blip2VisionModel](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2VisionModel)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **pooler_output** (`torch.Tensor`, shape `(batch_size, hidden_size)`) -- 시퀀스의 첫 번째 토큰(분류 토큰)의 마지막 레이어 hidden-state입니다. 보조 사전학습 작업을 위해 사용되는 레이어들을 통해 추가 처리된 값입니다. 예를 들어 BERT 계열 모델의 경우, 선형 레이어와 tanh 활성화 함수를 통해 처리된 분류 토큰을 반환합니다. 선형 레이어의 가중치는 사전학습 단계에서 다음 문장 예측(분류) 목적 함수를 통해 학습됩니다.
- **hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 형태는 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
## Blip2QFormerModel[[transformers.Blip2QFormerModel]]
#### transformers.Blip2QFormerModel[[transformers.Blip2QFormerModel]]
```python
transformers.Blip2QFormerModel(config: Blip2QFormerConfig)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L848)
**매개변수:**
config ([Blip2QFormerConfig](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2QFormerConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
BLIP-2 쿼리 트랜스포머(Q-Former).
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.Blip2QFormerModel.forward]]
```python
forward(query_embeds: Tensor, query_length: int | None = None, attention_mask: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L885)
**매개변수:**
query_embeds (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`) : attention 계산에 사용되는 hidden states입니다. cross-attention인 경우 query로 사용되며(즉, key와 value는 encoder_hidden_states를 사용합니다).
query_length (`int`, *선택 사항*) : 쿼리의 길이로, 일반적으로 쿼리 토큰 수를 기준으로 합니다. 값이 제공되지 않으면, query_length는 query_embeds에 의해 추론됩니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
encoder_hidden_states (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) : 인코더의 마지막 레이어 출력에서 생성된 hidden-states 시퀀스입니다. 모델이 디코더로 구성된 경우 cross-attention에 사용됩니다.
encoder_attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 인코더 입력의 패딩 토큰 인덱스에 대한 어텐션을 수행하지 않도록 하는 마스크입니다. 모델이 디코더로 구성된 경우 크로스 어텐션에서 이 마스크가 사용됩니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0.
**반환값:** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) 또는 `tuple(torch.Tensor)`
[BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되었거나 `config.return_dict=False`인 경우)로, 구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) 및 입력에 따라 다양한 요소를 포함합니다.
[Blip2QFormerModel](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2QFormerModel)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **pooler_output** (`torch.Tensor`, shape `(batch_size, hidden_size)`) -- 시퀀스의 첫 번째 토큰(분류 토큰)의 마지막 레이어 hidden-state입니다. 보조 사전학습 작업을 위해 사용되는 레이어들을 통해 추가 처리된 값입니다. 예를 들어 BERT 계열 모델의 경우, 선형 레이어와 tanh 활성화 함수를 통해 처리된 분류 토큰을 반환합니다. 선형 레이어의 가중치는 사전학습 단계에서 다음 문장 예측(분류) 목적 함수를 통해 학습됩니다.
- **hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 형태는 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple(torch.Tensor)`, *선택*, `output_attentions=True` 또는 `config.add_cross_attention=True`가 전달되거나 `config.output_attentions=True`인 경우 반환) -- 각 레이어당 하나씩, shape가 `(batch_size, num_heads, sequence_length, sequence_length)`인 `torch.Tensor`의 튜플.
decoder의 cross-attention 레이어에서 attention softmax를 적용한 후, cross-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention 가중치입니다.
- **past_key_values** (`Cache`, *선택 사항*, `use_cache=True`가 전달되었거나 `config.use_cache=True`인 경우 반환됨) -- [Cache](/docs/transformers/main/ko/internal/generation_utils#transformers.Cache) 인스턴스입니다. 자세한 내용은 [kv cache 가이드](https://huggingface.co/docs/transformers/en/kv_cache)를 참조하세요.
순차적 디코딩을 가속화하는 데 사용할 수 있는 사전 계산된 hidden-states(셀프 어텐션 블록의 key와 value, 그리고 `config.is_encoder_decoder=True`인 경우 크로스 어텐션 블록의 key와 value)를 포함합니다(입력 `past_key_values` 참조).
## Blip2Model[[transformers.Blip2Model]]
#### transformers.Blip2Model[[transformers.Blip2Model]]
```python
transformers.Blip2Model(config: Blip2Config)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L957)
**매개변수:**
config ([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
텍스트 및 이미지 특징을 생성하는 BLIP-2 모델. 이 모델은 비전 인코더, Querying Transformer(Q-Former), 언어 모델로 구성됩니다.
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.Blip2Model.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1152)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`) : 입력 이미지에 해당하는 텐서입니다. [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용하여 픽셀 값을 얻을 수 있습니다. 자세한 내용은 [BlipImageProcessor.__call__()](/docs/transformers/main/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)는 이미지 처리에 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용합니다).
input_ids (`torch.Tensor`, shape `(batch_size, sequence_length)`) : 어휘 사전에서 입력 시퀀스 토큰의 인덱스입니다. 기본적으로 패딩은 무시됩니다. [AutoTokenizer](/docs/transformers/main/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [PreTrainedTokenizer.encode()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 및 [PreTrainedTokenizer.__call__()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요. [입력 ID란 무엇인가요?](../glossary#input-ids)
attention_mask (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 어텐션 수행을 방지하기 위한 마스크. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [어텐션 마스크란?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor`, shape `(batch_size, target_sequence_length)`, *선택 사항*) : 어휘 내에서 디코더 입력 시퀀스 토큰의 인덱스입니다. [AutoTokenizer](/docs/transformers/main/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [PreTrainedTokenizer.encode()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 및 [PreTrainedTokenizer.__call__()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요. [디코더 입력 ID란 무엇인가요?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor`, shape `(batch_size, target_sequence_length)`, *선택 사항*) : 기본 동작: `decoder_input_ids`의 pad 토큰을 무시하는 텐서를 생성합니다. 기본적으로 Causal mask도 사용됩니다. 인코더-디코더 언어 모델(T5 등)을 사용하는 경우에만 관련이 있습니다.
labels (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : masked language modeling loss를 계산하기 위한 라벨. 인덱스는 `[0, ..., config.vocab_size]` 범위 내이거나 -100이어야 합니다(`input_ids` docstring 참조). 인덱스가 `-100`으로 설정된 토큰은 무시(마스크)되며, loss는 `[0, ..., config.vocab_size]` 범위의 라벨을 가진 토큰에 대해서만 계산됩니다.
interpolate_pos_encoding (`bool`, *선택 사항*, 기본값 `False`) : 사전 학습된 위치 인코딩을 보간할지 여부.
**반환값:** `Blip2ForConditionalGenerationModelOutput` 또는 `tuple(torch.Tensor)`
`Blip2ForConditionalGenerationModelOutput` 또는 `torch.Tensor`의 튜플(`return_dict=False`이 전달되거나 `config.return_dict=False`인 경우)로, 구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config))과 입력에 따라 다양한 요소를 포함합니다.
[Blip2Model](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Model)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, *선택 사항*, `labels`이 제공될 때 반환되며, `torch.Tensor` 형상 `(1,)`) -- 언어 모델에서 산출된 언어 모델링 손실.
- **logits** (`torch.Tensor`, shape `(batch_size, sequence_length, config.vocab_size)`) -- 언어 모델의 언어 모델링 헤드의 예측 점수입니다.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *선택 사항*) -- 비전 인코더의 출력입니다.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *선택 사항*) -- Q-Former(Querying Transformer)의 출력입니다.
- **language_model_outputs** (`CausalLMOutputWithPast` 또는 `Seq2SeqLMOutput`) -- 언어 모델의 출력입니다.
예:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2Model
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b", dtype=torch.float16)
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device, torch.float16)
>>> outputs = model(**inputs)
```
#### get_text_features[[transformers.Blip2Model.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L994)
**매개변수:**
input_ids (`torch.Tensor`, shape `(batch_size, sequence_length)`) : 어휘 사전에서 입력 시퀀스 토큰의 인덱스입니다. 기본적으로 패딩은 무시됩니다. [AutoTokenizer](/docs/transformers/main/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [PreTrainedTokenizer.encode()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 및 [PreTrainedTokenizer.__call__()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요. [입력 ID란 무엇인가요?](../glossary#input-ids)
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor`, shape `(batch_size, target_sequence_length)`, *선택 사항*) : 어휘에서 디코더 입력 시퀀스 토큰의 인덱스입니다. [AutoTokenizer](/docs/transformers/main/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [PreTrainedTokenizer.encode()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 및 [PreTrainedTokenizer.__call__()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요. [디코더 입력 ID란 무엇인가요?](../glossary#decoder-input-ids) T5는 `decoder_input_ids` 생성의 시작 토큰으로 `pad_token_id`를 사용합니다. `past_key_values`를 사용하는 경우, 선택적으로 마지막 `decoder_input_ids`만 입력하면 됩니다(`past_key_values` 참조). 사전 학습을 위해 `decoder_input_ids`를 준비하는 방법에 대해서는 [T5 Training](./t5#training)을 확인하세요.
decoder_attention_mask (`torch.BoolTensor`, shape `(batch_size, target_sequence_length)`, *선택 사항*) : 기본 동작: `decoder_input_ids`의 pad 토큰을 무시하는 텐서를 생성합니다. 기본적으로 Causal mask도 사용됩니다.
labels (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : masked language modeling loss를 계산하기 위한 라벨. 인덱스는 `[0, ..., config.vocab_size]` 범위 내이거나 -100이어야 합니다(`input_ids` docstring 참조). 인덱스가 `-100`으로 설정된 토큰은 무시(마스크)되며, loss는 `[0, ..., config.vocab_size]` 범위의 라벨을 가진 토큰에 대해서만 계산됩니다.
**반환값:** [BaseModelOutputWithPooling](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 또는 `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 또는 `torch.Tensor`의 튜플(`return_dict=False`이 전달되거나 `config.return_dict=False`인 경우)로, 구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) 및 입력에 따라 다양한 요소를 포함합니다.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **pooler_output** (`torch.Tensor`, shape `(batch_size, hidden_size)`) -- 시퀀스의 첫 번째 토큰(분류 토큰)의 마지막 레이어 hidden-state입니다. 보조 사전학습 작업을 위해 사용되는 레이어들을 통해 추가 처리된 값입니다. 예를 들어 BERT 계열 모델의 경우, 선형 레이어와 tanh 활성화 함수를 통해 처리된 분류 토큰을 반환합니다. 선형 레이어의 가중치는 사전학습 단계에서 다음 문장 예측(분류) 목적 함수를 통해 학습됩니다.
- **hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 형태는 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
예:
```python
>>> import torch
>>> from transformers import AutoTokenizer, Blip2Model
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> tokenizer = AutoTokenizer.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> inputs = tokenizer(["a photo of a cat"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.Blip2Model.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1056)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`) : 입력 이미지에 해당하는 텐서입니다. [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용하여 픽셀 값을 얻을 수 있습니다. 자세한 내용은 [BlipImageProcessor.__call__()](/docs/transformers/main/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)는 이미지 처리에 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용합니다).
interpolate_pos_encoding (`bool`, *선택 사항*, 기본값 `False`) : 사전 학습된 위치 인코딩을 보간할지 여부.
**반환값:** [BaseModelOutputWithPooling](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 또는 `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 또는 `torch.Tensor`의 튜플(`return_dict=False`이 전달되거나 `config.return_dict=False`인 경우)로, 구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) 및 입력에 따라 다양한 요소를 포함합니다.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **pooler_output** (`torch.Tensor`, shape `(batch_size, hidden_size)`) -- 시퀀스의 첫 번째 토큰(분류 토큰)의 마지막 레이어 hidden-state입니다. 보조 사전학습 작업을 위해 사용되는 레이어들을 통해 추가 처리된 값입니다. 예를 들어 BERT 계열 모델의 경우, 선형 레이어와 tanh 활성화 함수를 통해 처리된 분류 토큰을 반환합니다. 선형 레이어의 가중치는 사전학습 단계에서 다음 문장 예측(분류) 목적 함수를 통해 학습됩니다.
- **hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 형태는 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
예:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_outputs = model.get_image_features(**inputs)
```
#### get_qformer_features[[transformers.Blip2Model.get_qformer_features]]
```python
get_qformer_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1087)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`) : 입력 이미지에 해당하는 텐서입니다. [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용하여 픽셀 값을 얻을 수 있습니다. 자세한 내용은 [BlipImageProcessor.__call__()](/docs/transformers/main/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)는 이미지 처리에 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용합니다).
interpolate_pos_encoding (`bool`, *선택 사항*, 기본값 `False`) : 사전 학습된 위치 인코딩을 보간할지 여부.
**반환값:** qformer_outputs (`torch.Tensor`)
Q-Former 모델의 마지막 레이어 hidden states.
예:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2Model
>>> from transformers.image_utils import load_image
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2Model.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... qformer_outputs = model.get_qformer_features(**inputs)
```
## Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
#### transformers.Blip2ForConditionalGeneration[[transformers.Blip2ForConditionalGeneration]]
```python
transformers.Blip2ForConditionalGeneration(config: Blip2Config)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1460)
**매개변수:**
config ([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
이미지와 선택적 텍스트 프롬프트를 입력받아 텍스트를 생성하는 BLIP-2 모델입니다. 이 모델은 비전 인코더, Querying Transformer(Q-Former), 언어 모델로 구성됩니다.
모델에 `input_ids`를 선택적으로 전달할 수 있으며, 이는 텍스트 프롬프트 역할을 하여 언어 모델이 해당 프롬프트를 계속하도록 합니다. 그렇지 않으면 언어 모델은 [BOS](시퀀스 시작) 토큰부터 텍스트 생성을 시작합니다.
Flan-T5 체크포인트는 float16으로 캐스팅할 수 없습니다. bfloat16으로 사전 학습되었습니다.
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.Blip2ForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1587)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`) : 입력 이미지에 해당하는 텐서입니다. [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용하여 픽셀 값을 얻을 수 있습니다. 자세한 내용은 [BlipImageProcessor.__call__()](/docs/transformers/main/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)는 이미지 처리에 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용합니다).
input_ids (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 언어 모델 어휘에서 입력 시퀀스 토큰의 인덱스입니다. 입력 토큰은 선택적으로 제공하여 언어 모델이 계속할 수 있는 텍스트 프롬프트로 사용할 수 있습니다. 인덱스는 [Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [Blip2Processor.__call__()](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor.__call__)를 참조하세요. [입력 ID란 무엇인가요?](../glossary#input-ids)
attention_mask (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 어텐션 수행을 방지하기 위한 마스크. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [어텐션 마스크란?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor`, shape `(batch_size, target_sequence_length)`, *선택 사항*) : 어휘 내에서 디코더 입력 시퀀스 토큰의 인덱스입니다. [AutoTokenizer](/docs/transformers/main/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [PreTrainedTokenizer.encode()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 및 [PreTrainedTokenizer.__call__()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요. [디코더 입력 ID란 무엇인가요?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor`, shape `(batch_size, target_sequence_length)`, *선택 사항*) : 기본 동작: `decoder_input_ids`의 pad 토큰을 무시하는 텐서를 생성합니다. 기본적으로 Causal mask도 사용됩니다. 인코더-디코더 언어 모델(T5 등)을 사용하는 경우에만 관련이 있습니다.
inputs_embeds (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) : `input_ids`를 전달하는 대신 임베디드 표현을 직접 전달할 수 있습니다. 이는 모델의 내부 임베딩 조회 행렬보다 `input_ids` 인덱스를 관련 벡터로 변환하는 방식에 대해 더 많은 제어가 필요한 경우 유용합니다.
labels (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : masked language modeling loss를 계산하기 위한 라벨. 인덱스는 `[0, ..., config.vocab_size]` 범위 내이거나 -100이어야 합니다(`input_ids` docstring 참조). 인덱스가 `-100`으로 설정된 토큰은 무시(마스크)되며, loss는 `[0, ..., config.vocab_size]` 범위의 라벨을 가진 토큰에 대해서만 계산됩니다.
interpolate_pos_encoding (`bool`, *선택 사항*, 기본값 `False`) : 사전 학습된 위치 인코딩을 보간할지 여부.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *선택 사항*) : 키가 지원되는 모달리티이고 값이 해당 모달리티의 인코딩된 출력인 Dict입니다. 각 인코딩된 출력은 (`pooler_output`, *선택 사항*: `last_hidden_states`, *선택 사항*: `hidden_states`, *선택 사항*: `attentions`)의 튜플로 구성되며, `pooler_output`의 shape은 `(batch_size, sequence_length, hidden_size)`, *선택 사항*)입니다. 이는 인코더의 멀티모달 특징을 텍스트 임베딩으로 병합한 시퀀스입니다.
**반환값:** `Blip2ForConditionalGenerationModelOutput` 또는 `tuple(torch.Tensor)`
`Blip2ForConditionalGenerationModelOutput` 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되었거나 `config.return_dict=False`인 경우)로, 구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) 및 입력에 따라 다양한 요소를 포함합니다.
[Blip2ForConditionalGeneration](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2ForConditionalGeneration)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, *선택 사항*, `labels`이 제공될 때 반환되며, `torch.Tensor` 형상 `(1,)`) -- 언어 모델에서 산출된 언어 모델링 손실.
- **logits** (`torch.Tensor`, shape `(batch_size, sequence_length, config.vocab_size)`) -- 언어 모델의 언어 모델링 헤드에 대한 예측 점수입니다.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *선택 사항*) -- 비전 인코더의 출력입니다.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *선택 사항*) -- Q-Former(Querying Transformer)의 출력입니다.
- **language_model_outputs** (`CausalLMOutputWithPast` 또는 `Seq2SeqLMOutput`) -- 언어 모델의 출력입니다.
예:
프로세서, 모델 및 이미지 입력 준비
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import Blip2Processor, Blip2ForConditionalGeneration
>>> import torch
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = Blip2Processor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.float16
... ) # doctest: +IGNORE_RESULT
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
```
이미지 캡셔닝(텍스트 프롬프트 제공 없이):
```python
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two cats laying on a couch
```
시각 질의응답 (prompt = 질문):
```python
>>> prompt = "Question: how many cats are there? Answer:"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.float16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
int8 추론은 [bitsandbytes](https://github.com/TimDettmers/bitsandbytes)를 통해서도 지원됩니다. 이는 동일한 성능을 유지하면서 모델이 사용하는 메모리 양을 크게 줄여줍니다.
```python
>>> model = Blip2ForConditionalGeneration.from_pretrained(
... "Salesforce/blip2-opt-2.7b", load_in_8bit=True, device_map={"": 0}, dtype=torch.bfloat16
... ) # doctest: +IGNORE_RESULT
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device="cuda", dtype=torch.bfloat16)
>>> generated_ids = model.generate(**inputs)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
two
```
#### generate[[transformers.Blip2ForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1738)
**매개변수:**
pixel_values (`torch.Tensor`, shape: (batch_size, num_channels, height, width)) : 처리할 입력 이미지.
input_ids (`torch.LongTensor`, shape (batch_size, sequence_length), *선택 사항*) : 생성을 위한 프롬프트로 사용되는 시퀀스.
attention_mask (`torch.LongTensor`, shape (batch_size, sequence_length), *선택 사항*) : 패딩 토큰 인덱스에 대한 어텐션 수행을 방지하기 위한 마스크
inputs_embeds (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`) : 입력의 임베디드 표현입니다. int 토큰이 아닌 float여야 합니다.
interpolate_pos_encoding (`bool`, *선택 사항*, 기본값 `False`) : 이미지 임베딩의 위치 인코딩을 보간할지 여부입니다.
**반환값:** `captions (list)`
batch_size * num_captions 길이의 문자열 목록입니다.
`generate` 함수를 오버라이드하여 모델을 조건부 생성기로 사용할 수 있도록 합니다.
#### get_image_features[[transformers.Blip2ForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1519)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`) : 입력 이미지에 해당하는 텐서.
interpolate_pos_encoding (`bool`, *선택 사항*, 기본값 `False`) : 사전 학습된 위치 인코딩을 보간할지 여부.
**반환값:** `BaseModelOutputWithVisionQformerOutputs` 또는 `tuple(torch.Tensor)`
`BaseModelOutputWithVisionQformerOutputs` 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되었거나 `config.return_dict=False`인 경우)로, 구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) 및 입력에 따라 다양한 요소를 포함합니다.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **pooler_output** (`torch.Tensor`, shape `(batch_size, hidden_size)`) -- 시퀀스의 첫 번째 토큰(분류 토큰)의 마지막 레이어 hidden-state입니다. 보조 사전학습 작업을 위해 사용되는 레이어들을 통해 추가 처리된 값입니다. 예를 들어 BERT 계열 모델의 경우, 선형 레이어와 tanh 활성화 함수를 통해 처리된 분류 토큰을 반환합니다. 선형 레이어의 가중치는 사전학습 단계에서 다음 문장 예측(분류) 목적 함수를 통해 학습됩니다.
- **hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 형태는 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *선택 사항*) -- 비전 인코더의 출력입니다.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *선택 사항*) -- Q-Former(Querying Transformer)의 출력입니다.
예:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, Blip2ForConditionalGeneration
>>> model = Blip2ForConditionalGeneration.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-opt-2.7b")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```
## Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
#### transformers.Blip2ForImageTextRetrieval[[transformers.Blip2ForImageTextRetrieval]]
```python
transformers.Blip2ForImageTextRetrieval(config: Blip2Config)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1832)
**매개변수:**
config ([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
시각 및 텍스트 프로젝터와 상단의 분류 헤드를 갖춘 BLIP-2 모델입니다. 이 모델은 이미지-텍스트 검색 컨텍스트에서 사용됩니다. 이미지와 텍스트가 주어지면, 해당 텍스트가 이미지에 관련될 확률을 반환합니다.
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.Blip2ForImageTextRetrieval.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, attention_mask: typing.Optional[torch.LongTensor] = None, use_image_text_matching_head: bool | None = False, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1866)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`) : 입력 이미지에 해당하는 텐서입니다. [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용하여 픽셀 값을 얻을 수 있습니다. 자세한 내용은 [BlipImageProcessor.__call__()](/docs/transformers/main/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)는 이미지 처리에 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용합니다).
input_ids (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 언어 모델 어휘에서 입력 시퀀스 토큰의 인덱스입니다. 입력 토큰은 선택적으로 제공하여 언어 모델이 계속할 수 있는 텍스트 프롬프트로 사용할 수 있습니다. 인덱스는 [Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [Blip2Processor.__call__()](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor.__call__)를 참조하세요. [입력 ID란 무엇인가요?](../glossary#input-ids)
attention_mask (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 어텐션 수행을 방지하기 위한 마스크. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [어텐션 마스크란?](../glossary#attention-mask)
use_image_text_matching_head (`bool`, *선택 사항*) : Image-Text Matching 또는 Contrastive 점수를 반환할지 여부.
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/main/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
**반환값:** `Blip2ImageTextMatchingModelOutput` 또는 `tuple(torch.Tensor)`
`Blip2ImageTextMatchingModelOutput` 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우)로, 구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) 및 입력에 따라 다양한 요소를 포함합니다.
[Blip2ForImageTextRetrieval](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2ForImageTextRetrieval)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택 사항*, `return_loss`가 `True`일 때 반환됨) -- 이미지-텍스트 유사도를 위한 대조적 손실(contrastive loss).
- **logits_per_image** (`torch.Tensor`, shape `(image_batch_size, text_batch_size)`) -- `image_embeds`와 `text_embeds` 사이의 스케일된 도트 프로덕트 점수입니다. 이는 이미지-텍스트 유사도 점수를 나타냅니다.
- **logits_per_text** (`torch.Tensor`, shape `(text_batch_size, image_batch_size)`) -- `text_embeds`와 `image_embeds` 사이의 스케일된 도트 프로덕트 점수입니다. 이는 텍스트-이미지 유사도 점수를 나타냅니다.
- **text_embeds** (`torch.Tensor`, shape가 `(batch_size, output_dim`) -- pooled output에 projection layer를 적용하여 얻은 텍스트 임베딩입니다.
- **image_embeds** (`torch.Tensor`, shape `(batch_size, output_dim`) -- projection layer를 pooled output에 적용하여 얻은 이미지 임베딩입니다.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *선택 사항*) -- [Blip2QFormerModel](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2QFormerModel)의 출력입니다.
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *선택 사항*) -- [Blip2VisionModel](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2VisionModel)의 출력입니다.
예:
```python
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Blip2ForImageTextRetrieval
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2ForImageTextRetrieval.from_pretrained("Salesforce/blip2-itm-vit-g", dtype=torch.float16)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "two cats laying on a pink blanket"
>>> inputs = processor(images=image, text=text, return_tensors="pt").to(device, torch.float16)
>>> itm_out = model(**inputs, use_image_text_matching_head=True)
>>> logits_per_image = torch.nn.functional.softmax(itm_out.logits_per_image, dim=1)
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is not '{text}'")
26.9% that image 0 is not 'two cats laying on a pink blanket'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{text}'")
73.0% that image 0 is 'two cats laying on a pink blanket'
>>> texts = ["a photo of a cat", "a photo of a dog"]
>>> inputs = processor(images=image, text=texts, return_tensors="pt").to(device, torch.float16)
>>> itc_out = model(**inputs, use_image_text_matching_head=False)
>>> logits_per_image = itc_out.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(f"{probs[0][0]:.1%} that image 0 is '{texts[0]}'")
55.3% that image 0 is 'a photo of a cat'
>>> print(f"{probs[0][1]:.1%} that image 0 is '{texts[1]}'")
44.7% that image 0 is 'a photo of a dog'
```
## Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
#### transformers.Blip2TextModelWithProjection[[transformers.Blip2TextModelWithProjection]]
```python
transformers.Blip2TextModelWithProjection(config: Blip2Config)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1274)
**매개변수:**
config ([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
Blip 2 모델은 풀링된 출력 위에 투영 레이어(선형 레이어)를 포함합니다.
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.Blip2TextModelWithProjection.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1298)
**매개변수:**
input_ids (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 어휘(input sequence tokens)의 인덱스입니다. 기본적으로 패딩은 무시됩니다. [AutoTokenizer](/docs/transformers/main/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [PreTrainedTokenizer.encode()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 및 [PreTrainedTokenizer.__call__()](/docs/transformers/main/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요. [입력 ID란 무엇인가요?](../glossary#input-ids)
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
position_ids (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 각 입력 시퀀스의 토큰 위치 인덱스입니다. `[0, config.n_positions - 1]` 범위에서 선택됩니다. [위치 ID란 무엇인가요?](../glossary#position-ids)
**반환값:** `Blip2TextModelOutput` 또는 `tuple(torch.Tensor)`
`Blip2TextModelOutput` 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우)로, 구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config))과 입력에 따라 다양한 요소를 포함합니다.
[Blip2TextModelWithProjection](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2TextModelWithProjection)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **text_embeds** (`torch.Tensor`, shape `(batch_size, output_dim)`, *선택*, 모델이 `with_projection=True`로 초기화될 때 반환됨) -- pooler_output에 projection layer를 적용하여 얻은 텍스트 임베딩.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *선택*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환) -- shape가 `(batch_size, sequence_length, hidden_size)`인 `torch.Tensor`의 튜플 (모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 레이어 출력용 1개).
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor, ...]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor` 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
예:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2TextModelWithProjection
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model = Blip2TextModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> inputs = processor(text=["a photo of a cat", "a photo of a dog"], return_tensors="pt").to(device)
>>> outputs = model(**inputs)
>>> text_embeds = outputs.text_embeds
>>> print(text_embeds.shape)
torch.Size([2, 7, 256])
```
## Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
#### transformers.Blip2VisionModelWithProjection[[transformers.Blip2VisionModelWithProjection]]
```python
transformers.Blip2VisionModelWithProjection(config: Blip2Config)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1359)
**매개변수:**
config ([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
Blip 2 모델은 풀링된 출력 위에 투영 레이어(선형 레이어)를 포함합니다.
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.Blip2VisionModelWithProjection.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/blip_2/modeling_blip_2.py#L1382)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`, *선택 사항*) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [BlipImageProcessor.__call__()](/docs/transformers/main/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([Blip2Processor](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Processor)는 이미지 처리에 [BlipImageProcessor](/docs/transformers/main/ko/model_doc/blip#transformers.BlipImageProcessor)를 사용합니다).
**반환값:** `Blip2VisionModelOutput` 또는 `tuple(torch.Tensor)`
구성([Blip2Config](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2Config))과 입력에 따라 다양한 요소를 포함하는 `Blip2VisionModelOutput` 또는 `torch.Tensor`의 튜플(`return_dict=False`이 전달되거나 `config.return_dict=False`인 경우)입니다.
[Blip2VisionModelWithProjection](/docs/transformers/main/ko/model_doc/blip-2#transformers.Blip2VisionModelWithProjection)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **image_embeds** (`torch.Tensor`, shape `(batch_size, output_dim)`, *선택*, 모델이 `with_projection=True`로 초기화되었을 때 반환) -- pooler_output에 projection layer를 적용하여 얻은 이미지 임베딩.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *선택*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환) -- shape가 `(batch_size, sequence_length, hidden_size)`인 `torch.Tensor`의 튜플 (모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개).
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor, ...]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor` 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
예:
```python
>>> import torch
>>> from transformers import AutoProcessor, Blip2VisionModelWithProjection
>>> from transformers.image_utils import load_image
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> processor = AutoProcessor.from_pretrained("Salesforce/blip2-itm-vit-g")
>>> model = Blip2VisionModelWithProjection.from_pretrained(
... "Salesforce/blip2-itm-vit-g", dtype=torch.float16
... )
>>> model.to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt").to(device, torch.float16)
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> image_embeds = outputs.image_embeds
>>> print(image_embeds.shape)
torch.Size([1, 32, 256])
```