# SAM
## Обзор
SAM (Segment Anything Model) был предложен в [Segment Anything](https://huggingface.co/papers/2304.02643) Александром Кирилловым, Эриком Минтуном, Нихила Рави, Ханьци Мао, Шлоэ Роллан, Лорой Густафсон, Тете Сяо, Спенсером Уайтхедом, Алексом Бергом, Ван-Ян Ло, Пьотром Долларом и Россом Гиршиком.
Модель можно использовать для предсказания сегментационных масок любого объекта интереса по входному изображению.
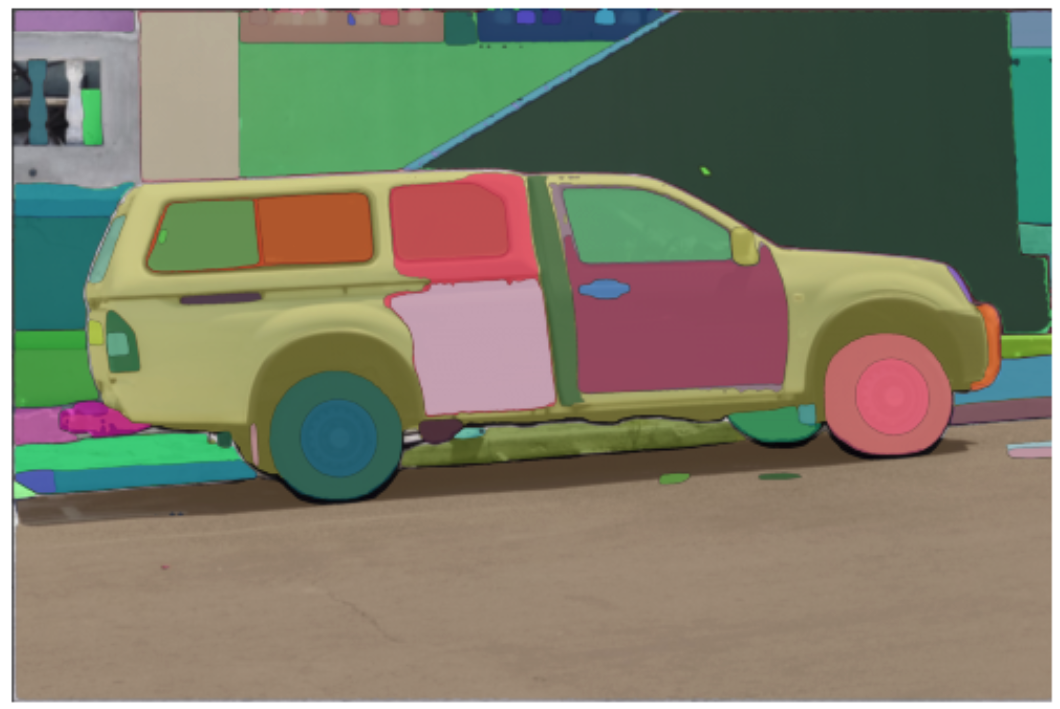
Аннотация из статьи следующая:
*Мы представляем проект Segment Anything (SA): новую задачу, модель и набор данных для сегментации изображений. Используя нашу эффективную модель в цикле сбора данных, мы создали крупнейший на сегодняшний день (значительно превосходящий все предыдущие) набор данных для сегментации, содержащий более 1 миллиарда масок для 11 млн изображений с лицензиями и с соблюдением конфиденциальности. Модель спроектирована и обучена для работы по запросу (promptable), что позволяет переносить её в режиме zero-shot на новые распределения изображений и задачи. Мы оцениваем её возможности на множестве задач и обнаруживаем, что её zero-shot производительность впечатляет — часто она конкурентоспособна с ранее полученными результатами полностью контролируемого обучения или даже превосходит их. Мы публикуем модель Segment Anything (SAM) и соответствующий набор данных (SA-1B), содержащий 1 млрд масок и 11 млн изображений, по адресу [https://segment-anything.com](https://segment-anything.com), чтобы стимулировать исследования базовых моделей для компьютерного зрения.*
Советы:
- Модель предсказывает бинарные маски, указывающие на наличие или отсутствие объекта интереса на изображении.
- Модель предсказывает значительно лучшие результаты, если на вход подаются 2D-точки и/или ограничивающие рамки (bounding boxes).
- Вы можете указать несколько точек для одного и того же изображения и предсказать единую маску.
- Настройка модели пока не поддерживается
- Согласно статье, должна поддерживаться и текстовая входная информация. Однако на момент написания этого текста, судя по [официальному репозиторию](https://github.com/facebookresearch/segment-anything/issues/4#issuecomment-1497626844), такая поддержка отсутствует.
Эта модель была добавлена [ybelkada](https://huggingface.co/ybelkada) и [ArthurZ](https://huggingface.co/ArthurZ). Исходный код можно найти [здесь](https://github.com/facebookresearch/segment-anything).
Ниже приведен пример того, как запустить генерацию маски, имея изображение и 2D-точку:
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
Вы также можете обрабатывать собственные маски вместе с входными изображениями в процессоре, чтобы передать их в модель.
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
## Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены значком 🌎), которые помогут вам начать работу с SAM.
- [Демо-ноутбук](https://github.com/huggingface/notebooks/blob/main/examples/segment_anything.ipynb) для использования модели.
- [Демо-ноутбук](https://github.com/huggingface/notebooks/blob/main/examples/automatic_mask_generation.ipynb) для использования конвейера автоматической генерации масок.
- [Демо-ноутбук](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Run_inference_with_MedSAM_using_HuggingFace_Transformers.ipynb) для инференса с MedSAM — дообученной версией SAM для медицинской области. 🌎
- [Демо-ноутбук](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Fine_tune_SAM_(segment_anything)_on_a_custom_dataset.ipynb) для дообучения модели на собственных данных. 🌎
## SlimSAM
SlimSAM, прuned-версия SAM, была предложена в статье [0.1% Data Makes Segment Anything Slim](https://huggingface.co/papers/2312.05284) Zigeng Chen и соавторами. SlimSAM значительно уменьшает размер моделей SAM, сохраняя при этом тот же уровень производительности.
Чекпоинты можно найти на [хабе](https://huggingface.co/models?other=slimsam), и их можно использовать как прямую замену SAM.
## Grounded SAM
Можно объединить [Grounding DINO](grounding-dino) с SAM для генерации масок по текстовому запросу, как описано в статье [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159). Подробности можно найти в этой [демо-тетради](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍.
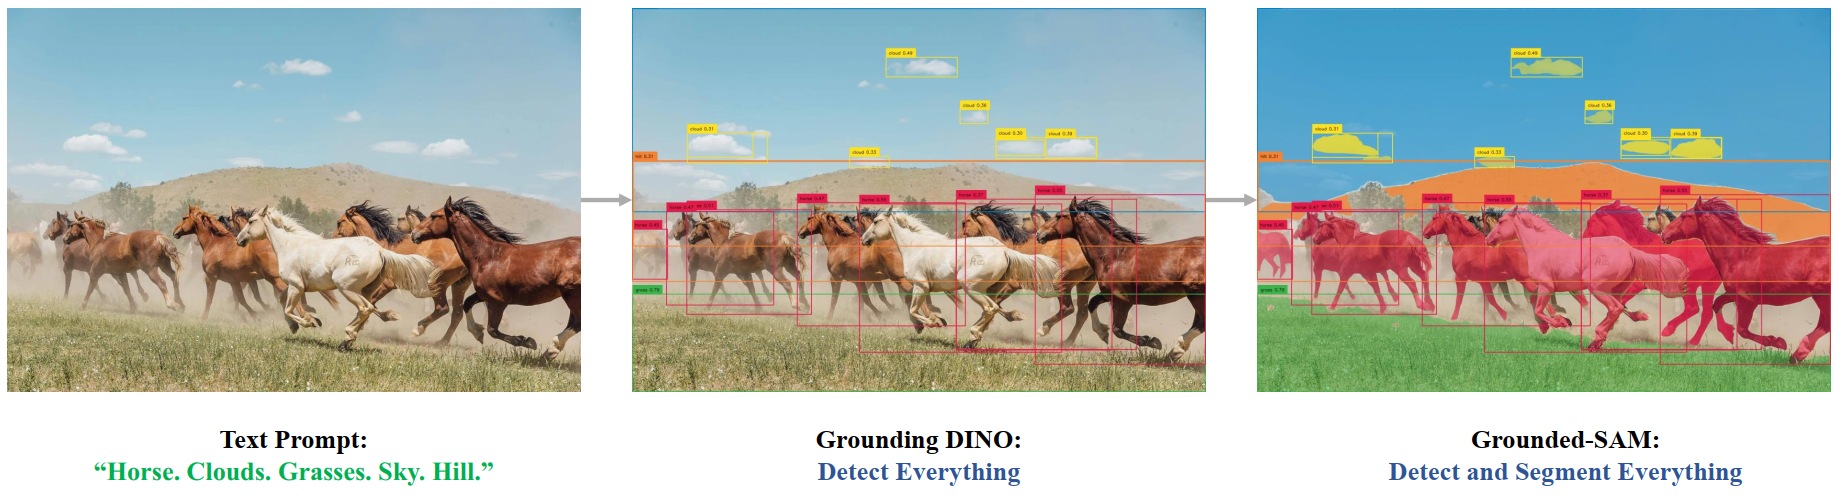 Обзор Grounded SAM. Изображение взято из исходного репозитория.
## SamConfig[[transformers.SamConfig]]
#### transformers.SamConfig[[transformers.SamConfig]]
```python
transformers.SamConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, prompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, mask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, initializer_range: float = 0.02, tie_word_embeddings: bool = True)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L146)
**Параметры:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь для визуального бэкбона.
prompt_encoder_config (Union[`dict`, `SamPromptEncoderConfig`], *optional*) : Словарь параметров конфигурации, используемых для инициализации [SamPromptEncoderConfig](/docs/transformers/main/ru/model_doc/sam#transformers.SamPromptEncoderConfig).
mask_decoder_config (Union[`dict`, `SamMaskDecoderConfig`], *optional*) : Словарь параметров конфигурации, используемых для инициализации [SamMaskDecoderConfig](/docs/transformers/main/ru/model_doc/sam#transformers.SamMaskDecoderConfig).
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
tie_word_embeddings (`bool`, *необязательный*, по умолчанию `True`) : Связывать ли веса эмбеддингов согласно отображению `tied_weights_keys` модели.
Это класс конфигурации для хранения настроек модели SamModel. Он используется для создания модели Sam в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import (
... SamVisionConfig,
... SamPromptEncoderConfig,
... SamMaskDecoderConfig,
... SamModel,
... )
>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()
>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig
>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()
>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
```
## SamVisionConfig[[transformers.SamVisionConfig]]
#### transformers.SamVisionConfig[[transformers.SamVisionConfig]]
```python
transformers.SamVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, output_channels: int = 256, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True, mlp_ratio: float = 4.0, use_abs_pos: bool = True, use_rel_pos: bool = True, window_size: int = 14, global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11), num_pos_feats: int = 128, mlp_dim: int | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L81)
**Параметры:**
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
output_channels (`int`, *optional*, по умолчанию 256) : Размерность выходных каналов в Patch Encoder.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
num_channels (`int`, *необязательный*, по умолчанию `3`) : Количество входных каналов.
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `1024`) : Размер (разрешение) каждого изображения.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `16`) : Размер (разрешение) каждого патча.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-06`) : Значение epsilon, используемое слоями нормализации.
attention_dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
initializer_range (`float`, *optional*, по умолчанию `1e-10`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
qkv_bias (`bool`, *необязательный*, по умолчанию `True`) : Добавлять ли смещение (bias) к запросам, ключам и значениям.
mlp_ratio (`float`, *необязательный*, по умолчанию `4.0`) : Соотношение скрытого размера MLP к размеру эмбеддинга.
use_abs_pos (`bool`, *необязательный*, по умолчанию `True`) : Использовать ли абсолютные позиционные эмбеддинги.
use_rel_pos (`bool`, *необязательный*, по умолчанию `True`) : Использовать ли встраивание относительных позиций.
window_size (`int`, *optional*, по умолчанию 14) : Размер окна для относительного положения.
global_attn_indexes (`list[int]`, *необязательный*, по умолчанию `[2, 5, 8, 11]`) : Индексы глобальных слоев внимания.
num_pos_feats (`int`, *optional*, по умолчанию 128) : Размерность позиционного эмбеддинга.
mlp_dim (`int`, *optional*) : Размерность слоя MLP в кодере Transformer. Если `None`, по умолчанию используется `mlp_ratio * hidden_size`.
Это класс конфигурации для хранения настроек модели SamModel. Он используется для создания модели Sam в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import (
... SamVisionConfig,
... SamVisionModel,
... )
>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()
>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
#### transformers.SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
```python
transformers.SamMaskDecoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, hidden_act: str = 'relu', mlp_dim: int = 2048, num_hidden_layers: int = 2, num_attention_heads: int = 8, attention_downsample_rate: int = 2, num_multimask_outputs: int = 3, iou_head_depth: int = 3, iou_head_hidden_dim: int = 256, layer_norm_eps: float = 1e-06)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L50)
**Параметры:**
hidden_size (`int`, *optional*, по умолчанию `256`) : Размерность скрытых представлений.
hidden_act (`str`, *необязательный*, по умолчанию `relu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
mlp_dim (`int`, *optional*, по умолчанию 2048) : Размерность «промежуточного» (т.е. полносвязного) слоя в кодере Transformer.
num_hidden_layers (`int`, *необязательный*, по умолчанию `2`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `8`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
attention_downsample_rate (`int`, *optional*, по умолчанию 2) : Коэффициент понижающей дискретизации слоя внимания.
num_multimask_outputs (`int`, *optional*, по умолчанию 3) : Количество выходов модуля `SamMaskDecoder`. В статье Segment Anything это значение установлено в 3.
iou_head_depth (`int`, *optional*, по умолчанию 3) : Количество слоёв в модуле IoU head.
iou_head_hidden_dim (`int`, *optional*, по умолчанию 256) : Размерность скрытых состояний в модуле IoU head.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-06`) : Значение epsilon, используемое слоями нормализации.
Это класс конфигурации для хранения настроек модели SamModel. Он используется для создания модели Sam в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig).
## SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
#### transformers.SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
```python
transformers.SamPromptEncoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, mask_input_channels: int = 16, num_point_embeddings: int = 4, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L24)
**Параметры:**
hidden_size (`int`, *optional*, по умолчанию `256`) : Размерность скрытых представлений.
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `1024`) : Размер (разрешение) каждого изображения.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `16`) : Размер (разрешение) каждого патча.
mask_input_channels (`int`, *необязательный*, по умолчанию 16) : Количество каналов, передаваемых в модуль `MaskDecoder`.
num_point_embeddings (`int`, *optional*, по умолчанию 4) : Количество используемых встраиваний точек.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-06`) : Значение epsilon, используемое слоями нормализации.
Это класс конфигурации для хранения настроек модели SamModel. Он используется для создания модели Sam в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig).
## SamProcessor[[transformers.SamProcessor]]
#### transformers.SamProcessor[[transformers.SamProcessor]]
```python
transformers.SamProcessor(image_processor)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/processing_sam.py#L82)
**Параметры:**
image_processor (`SamImageProcessor`) : процессор изображений является обязательным входным параметром.
Создаёт SamProcessor, который объединяет image processor в единый processor.
[SamProcessor](/docs/transformers/main/ru/model_doc/sam#transformers.SamProcessor) предоставляет все возможности [SamImageProcessor](/docs/transformers/main/ru/model_doc/sam#transformers.SamImageProcessor). Подробнее см. в [~SamImageProcessor](/docs/transformers/main/ru/model_doc/sam#transformers.SamImageProcessor).
#### __call__[[transformers.SamProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/processing_sam.py#L87)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *необязательный*) : Изображение для предварительной обработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *необязательный*) : Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если вы передаёте предтокенизированный вход, установите `is_split_into_words=True`, чтобы избежать неоднозначности с батчированными входами.
return_tensors (`str` или [TensorType](/docs/transformers/main/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
**Возвращает:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *необязательный*) -- Словарь списков/массивов/тензоров, возвращаемый методами `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask' и т. д.).
- **encoding** (`tokenizers.Encoding` или `Sequence[tokenizers.Encoding]`, *необязательный*) -- Если токенизатор является быстрым токенизатором, который выводит дополнительную информацию, например, отображение из пространства слов/символов в пространство токенов, то экземпляр `tokenizers.Encoding` или список экземпляров (для батчей) содержит эту информацию.
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
- **prepend_batch_axis** (`bool`, *необязательный*, по умолчанию `False`) — добавлять ли ось батча при преобразовании в тензоры (см. `tensor_type` выше). Обратите внимание, что этот параметр имеет значение, если параметр `tensor_type` задан, *иначе не влияет на результат*.
- **n_sequences** (`int`, *необязательный*) -- Количество входных последовательностей, представленных каждым кодированием (`None` для неизвестного значения, `1` для одной последовательности и `2` для пары последовательностей).
## SamImageProcessor[[transformers.SamImageProcessor]]
#### transformers.SamImageProcessor[[transformers.SamImageProcessor]]
```python
transformers.SamImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_sam.py#L61)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*, по умолчанию `True`) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'longest_edge' : 1024}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 1024, 'width': 1024}`): размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
mask_size (`dict[str, *kwargs*, int]`, *необязательный*) : Размер `{"longest_edge": int}`, до которого следует изменить размер карт сегментации.
mask_pad_size (`dict[str, *kwargs*, int]`, *необязательный*) : Размер `{"height": int, "width": int}`, до которого следует дополнять карты сегментации. Должен быть больше любого размера карты сегментации, предоставленного для предобработки.
Создаёт процессор изображений SamImageProcessor.
#### preprocess[[transformers.SamImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_sam.py#L79)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
segmentation_maps (`ImageInput`, *необязательный*) : карты сегментации для предварительной обработки.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
mask_size (`dict[str, *kwargs*, int]`, *необязательный*) : Размер `{"longest_edge": int}`, до которого следует изменить размер карт сегментации.
mask_pad_size (`dict[str, *kwargs*, int]`, *необязательный*) : Размер `{"height": int, "width": int}`, до которого следует дополнять карты сегментации. Должен быть больше любого размера карты сегментации, предоставленного для предобработки.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## SamImageProcessorPil[[transformers.SamImageProcessorPil]]
#### transformers.SamImageProcessorPil[[transformers.SamImageProcessorPil]]
```python
transformers.SamImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_pil_sam.py#L82)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*, по умолчанию `True`) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'longest_edge' : 1024}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 1024, 'width': 1024}`): размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
mask_size (`dict[str, *kwargs*, int]`, *необязательный*) : Размер `{"longest_edge": int}`, до которого следует изменить размер карт сегментации.
mask_pad_size (`dict[str, *kwargs*, int]`, *необязательный*) : Размер `{"height": int, "width": int}`, до которого следует дополнять карты сегментации. Должен быть больше любого размера карты сегментации, предоставленного для предобработки.
Создаёт процессор изображений SamImageProcessor.
#### preprocess[[transformers.SamImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_pil_sam.py#L100)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
segmentation_maps (`ImageInput`, *необязательный*) : карты сегментации для предварительной обработки.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
mask_size (`dict[str, *kwargs*, int]`, *необязательный*) : Размер `{"longest_edge": int}`, до которого следует изменить размер карт сегментации.
mask_pad_size (`dict[str, *kwargs*, int]`, *необязательный*) : Размер `{"height": int, "width": int}`, до которого следует дополнять карты сегментации. Должен быть больше любого размера карты сегментации, предоставленного для предобработки.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## SamVisionModel[[transformers.SamVisionModel]]
#### transformers.SamVisionModel[[transformers.SamVisionModel]]
```python
transformers.SamVisionModel(config: SamVisionConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1081)
**Параметры:**
config ([SamVisionConfig](/docs/transformers/main/ru/model_doc/sam#transformers.SamVisionConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель зрения от Sam без какой-либо головы или проекции сверху.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.SamVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1093)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [SamImageProcessor](/docs/transformers/main/ru/model_doc/sam#transformers.SamImageProcessor). Подробности см. в [SamImageProcessor.__call__()](/docs/transformers/main/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([SamProcessor](/docs/transformers/main/ru/model_doc/sam#transformers.SamProcessor) использует [SamImageProcessor](/docs/transformers/main/ru/model_doc/sam#transformers.SamImageProcessor) для обработки изображений).
**Возвращает:** `SamVisionEncoderOutput` или `tuple(torch.Tensor)`
Объект `SamVisionEncoderOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([SamConfig](/docs/transformers/main/ru/model_doc/sam#transformers.SamConfig)) и входных данных.
Метод forward модели [SamVisionModel](/docs/transformers/main/ru/model_doc/sam#transformers.SamVisionModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **image_embeds** (`torch.Tensor` формы `(batch_size, output_dim)` *необязательный*, возвращается при инициализации модели с `with_projection=True`) -- Векторы изображений, полученные применением слоя проекции к pooler_output.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor, ...]`, *необязательный*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
## SamModel[[transformers.SamModel]]
#### transformers.SamModel[[transformers.SamModel]]
```python
transformers.SamModel(config: SamConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1108)
**Параметры:**
config ([SamConfig](/docs/transformers/main/ru/model_doc/sam#transformers.SamConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Segment Anything Model (SAM) для генерации масок сегментации по входному изображению и входным точкам с метками, рамкам или маскам.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.SamModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, input_points: typing.Optional[torch.Tensor] = None, input_labels: typing.Optional[torch.LongTensor] = None, input_boxes: typing.Optional[torch.Tensor] = None, input_masks: typing.Optional[torch.LongTensor] = None, image_embeddings: typing.Optional[torch.Tensor] = None, multimask_output: bool = True, attention_similarity: typing.Optional[torch.Tensor] = None, target_embedding: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1191)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [SamImageProcessor](/docs/transformers/main/ru/model_doc/sam#transformers.SamImageProcessor). Подробности см. в [SamImageProcessor.__call__()](/docs/transformers/main/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([SamProcessor](/docs/transformers/main/ru/model_doc/sam#transformers.SamProcessor) использует [SamImageProcessor](/docs/transformers/main/ru/model_doc/sam#transformers.SamImageProcessor) для обработки изображений).
input_points (`torch.Tensor` формы `(batch_size, num_points, 2)`) : Входные 2D пространственные точки, которые используются кодировщиком промпта для кодирования промпта. Как правило, это даёт значительно лучшие результаты. Точки можно получить, передав в процессор список списков списков, который создаст соответствующие тензоры `torch` размерности 4. Первая размерность — размер батча изображений, вторая — размер батча точек (то есть сколько сегментационных масок модель должна предсказать на каждую входную точку), третья — количество точек на сегментационную маску (можно передать несколько точек для одной маски), а последняя — координаты x (вертикальная) и y (горизонтальная) точки. Если для каждого изображения или для каждой маски передано разное количество точек, процессор создаст точки «PAD», соответствующие координате (0, 0), и вычисление эмбеддинга для этих точек будет пропущено с помощью меток.
input_labels (`torch.LongTensor` формы `(batch_size, point_batch_size, num_points)`) : Входные метки для точек, используются кодировщиком промпта для кодирования промпта. Согласно официальному реализованию, существует 3 типа меток - `1`: точка содержит объект интереса - `0`: точка не содержит объект интереса - `-1`: точка соответствует фону Мы добавили метку: - `-10`: точка является заполнителем (padding), поэтому должна игнорироваться кодировщиком промпта Метки заполнения должны назначаться автоматически процессором.
input_boxes (`torch.Tensor` формы `(batch_size, num_boxes, 4)`) : Входные рамки для точек, используются кодировщиком подсказок для кодирования подсказки. Как правило, это приводит к значительно более качественным сгенерированным маскам. Рамки можно получить, передав в процессор список списков списков, который сгенерирует тензор `torch`, где каждое измерение соответствует соответственно размеру батча изображений, количеству рамок на изображение и координатам верхней левой и нижней правой точек рамки. В порядке (`x1`, `y1`, `x2`, `y2`): - `x1`: координата x верхней левой точки входной рамки - `y1`: координата y верхней левой точки входной рамки - `x2`: координата x нижней правой точки входной рамки - `y2`: координата y нижней правой точки входной рамки
input_masks (`torch.Tensor` формы `(batch_size, image_size, image_size)`) : Модель SAM также принимает в качестве входных данных маски сегментации. Маска будет встроена с помощью кодировщика подсказок для генерации соответствующего встраивания, которое затем будет передано декодеру масок. Эти маски необходимо вручную передавать пользователем, и они должны иметь форму (`batch_size`, `image_size`, `image_size`).
image_embeddings (`torch.Tensor` формы `(batch_size, output_channels, window_size, window_size)`) : Вложения изображений, которые используются декодером маски для генерации масок и оценок IoU. Для более эффективного использования памяти пользователи могут сначала получить вложения изображений с помощью метода `get_image_embeddings`, а затем передать их в метод `forward` вместо передачи `pixel_values`.
multimask_output (`bool`, *необязательный*) : В исходной реализации и статье модель всегда выводит 3 маски на изображение (или на точку / на ограничивающий прямоугольник, если это применимо). Однако можно вывести только одну маску, соответствующую «лучшей» маске, указав `multimask_output=False`.
attention_similarity (`torch.Tensor`, *необязательный*) : тензор сходства внимания, который передается декодеру маски для целевого управления вниманием в случае, если модель используется для персонализации, как описано в [PerSAM](https://huggingface.co/papers/2305.03048).
target_embedding (`torch.Tensor`, *необязательный*) : Вложение целевого концепта, которое передается декодеру маски для семантического промптинга цели, если модель используется для персонализации, как описано в [PerSAM](https://huggingface.co/papers/2305.03048).
**Возвращает:** `SamImageSegmentationOutput` или `tuple(torch.Tensor)`
Объект `SamImageSegmentationOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([SamConfig](/docs/transformers/main/ru/model_doc/sam#transformers.SamConfig)) и входных данных.
Метод forward класса [SamModel](/docs/transformers/main/ru/model_doc/sam#transformers.SamModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **iou_scores** (`torch.Tensor` формы `(batch_size, num_masks)`) -- Оценки iou для предсказанных масок.
- **pred_masks** (`torch.Tensor` формы `(batch_size, num_masks, height, width)`) -- Предсказанные маски низкого разрешения. Требуют постобработки процессором
- **vision_hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели зрения на выходе каждого слоя, а также необязательные выходные значения начального эмбеддинга.
- **vision_attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **mask_decoder_attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Пример:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor
>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")
>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
... raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]] # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")
>>> # Get segmentation mask
>>> outputs = model(**inputs)
>>> # Postprocess masks
>>> masks = processor.post_process_masks(
... outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )
```