# X-CLIP
## Tổng quan
Mô hình X-CLIP được đề xuất trong [Expanding Language-Image Pretrained Models for General Video Recognition](https://huggingface.co/papers/2208.02816) bởi Bolin Ni, Houwen Peng, Minghao Chen, Songyang Zhang, Gaofeng Meng, Jianlong Fu, Shiming Xiang, Haibin Ling. X-CLIP là một mở rộng tối thiểu của [CLIP](clip) cho video. Mô hình bao gồm một bộ mã hóa văn bản, một bộ mã hóa thị giác liên khung, một Transformer tích hợp đa khung và một bộ tạo prompt đặc thù cho video.
Tóm tắt từ bài báo như sau:
*Pretraining đối chiếu ngôn ngữ-hình ảnh đã chứng tỏ thành công lớn trong việc học biểu diễn liên hợp thị giác-văn bản từ dữ liệu quy mô web, thể hiện khả năng tổng quát hóa "zero-shot" đáng kể cho nhiều tác vụ hình ảnh. Tuy nhiên, làm thế nào để mở rộng hiệu quả các phương pháp pretraining ngôn ngữ-hình ảnh mới này sang lĩnh vực video vẫn là một vấn đề mở. Trong công việc này, chúng tôi đề xuất một cách tiếp cận đơn giản nhưng hiệu quả, điều chỉnh các mô hình ngôn ngữ-hình ảnh đã được pretraining để áp dụng trực tiếp cho nhận dạng video, thay vì pretraining một mô hình mới từ đầu. Cụ thể hơn, để nắm bắt các phụ thuộc tầm xa của các khung hình dọc theo chiều thời gian, chúng tôi đề xuất một cơ chế chú ý liên khung hình (cross-frame attention) trao đổi thông tin một cách tường minh giữa các khung hình. Module này nhẹ nhàng và có thể được tích hợp liền mạch vào các mô hình ngôn ngữ-hình ảnh đã được pretraining. Hơn nữa, chúng tôi đề xuất một phương án prompting đặc thù cho video, tận dụng thông tin nội dung video để tạo ra các prompt văn bản có tính phân biệt cao. Các thí nghiệm rộng rãi cho thấy cách tiếp cận của chúng tôi hiệu quả và có thể tổng quát hóa sang các kịch bản nhận dạng video khác nhau. Cụ thể, trong cài đặt giám sát đầy đủ (fully-supervised), cách tiếp cận của chúng tôi đạt độ chính xác top-1 là 87,1% trên Kinectics-400, trong khi sử dụng ít hơn 12 lần FLOPs so với Swin-L và ViViT-H. Trong các thí nghiệm zero-shot, cách tiếp cận của chúng tôi vượt qua các phương pháp tiên tiến hiện tại +7,6% và +14,9% về độ chính xác top-1 dưới hai giao thức phổ biến. Trong các kịch bản few-shot, cách tiếp cận của chúng tôi vượt trội hơn các phương pháp tốt nhất trước đó +32,1% và +23,1% khi dữ liệu có nhãn cực kỳ hạn chế.*
Mẹo:
- Cách sử dụng X-CLIP giống hệt với [CLIP](clip).
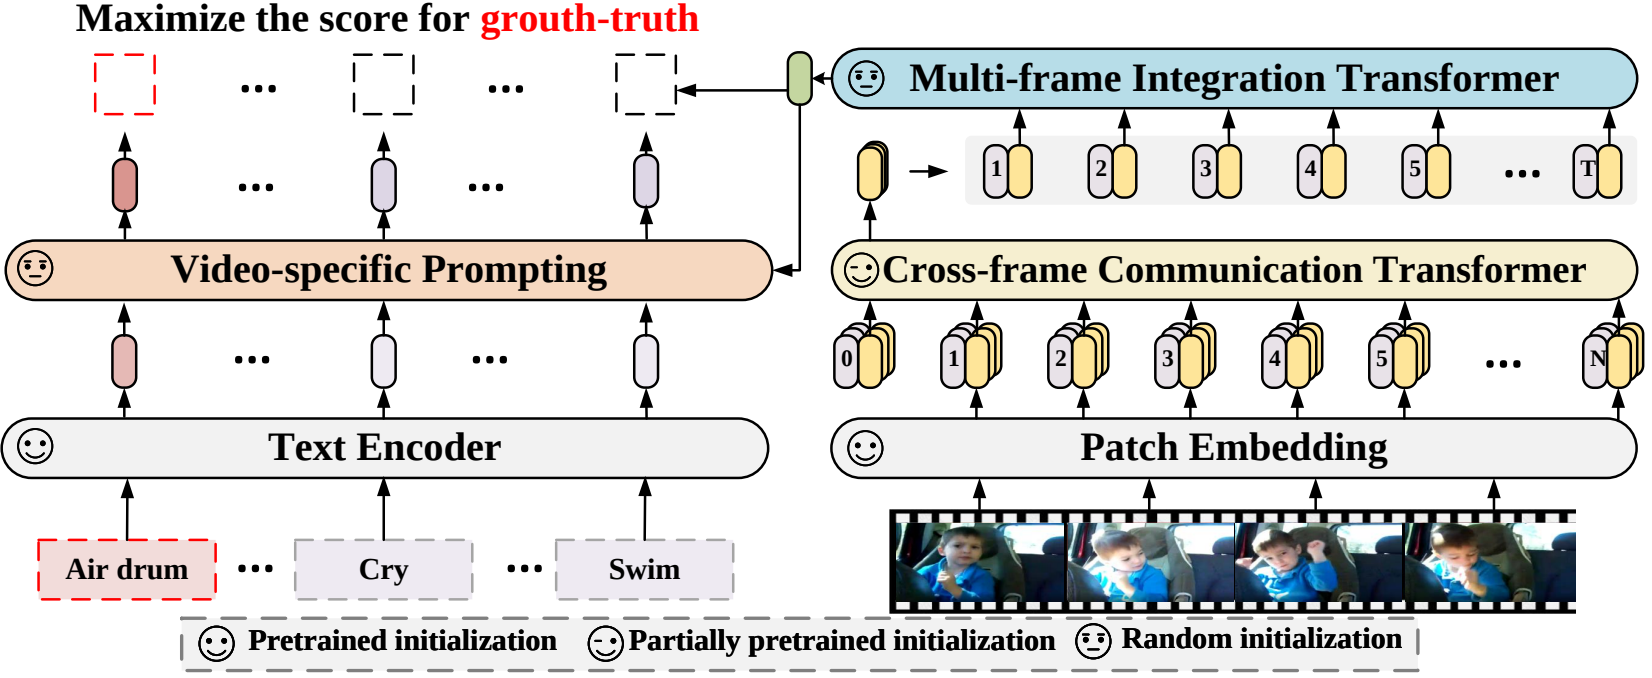 Kiến trúc X-CLIP. Được trích từ bài báo gốc.
Mô hình này được đóng góp bởi [nielsr](https://huggingface.co/nielsr). Mã gốc có thể được tìm thấy [tại đây](https://github.com/microsoft/VideoX/tree/master/X-CLIP).
## Tài nguyên
Danh sách các tài nguyên chính thức của Hugging Face và cộng đồng (được đánh dấu bằng 🌎) để giúp bạn bắt đầu với X-CLIP.
- Các notebook demo cho X-CLIP có thể được tìm thấy [tại đây](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/X-CLIP).
Nếu bạn quan tâm đến việc gửi một tài nguyên để được đưa vào đây, hãy thoải mái mở một Pull Request và chúng tôi sẽ xem xét! Lý tưởng nhất là tài nguyên nên minh họa một điều gì đó mới thay vì sao chép một tài nguyên hiện có.
## XCLIPProcessor[[transformers.XCLIPProcessor]]
#### transformers.XCLIPProcessor[[transformers.XCLIPProcessor]]
```python
transformers.XCLIPProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/processing_x_clip.py#L23)
**Tham số:**
image_processor (`image_processor_class`) : Bộ xử lý ảnh là một đầu vào bắt buộc.
tokenizer (`tokenizer_class`) : Tokenizer là đầu vào bắt buộc.
Tạo một XCLIPProcessor đóng gói một bộ xử lý ảnh và một tokenizer thành một bộ xử lý duy nhất.
[XCLIPProcessor](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPProcessor) cung cấp đầy đủ các chức năng của `image_processor_class` và `tokenizer_class`. Xem `~image_processor_class` và `~tokenizer_class` để biết thêm thông tin.
#### __call__[[transformers.XCLIPProcessor.__call__]]
```python
__call__(images = None, text = None, videos = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/processing_x_clip.py#L28)
## XCLIPConfig[[transformers.XCLIPConfig]]
#### transformers.XCLIPConfig[[transformers.XCLIPConfig]]
```python
transformers.XCLIPConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, prompt_layers: int = 2, prompt_alpha: float = 0.1, prompt_hidden_act: str = 'quick_gelu', prompt_num_attention_heads: int = 8, prompt_attention_dropout: float | int = 0.0, prompt_projection_dropout: float | int = 0.0, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/configuration_x_clip.py#L119)
**Tham số:**
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *tùy chọn*) : Đối tượng config hoặc từ điển của text backbone.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *tùy chọn*) : Đối tượng config hoặc từ điển của vision backbone.
projection_dim (`int`, *optional*, mặc định là `512`) : Độ chiều của các lớp chiếu văn bản và thị giác.
prompt_layers (`int`, *tuỳ chọn*, mặc định là 2) : Số lượng lớp trong trình tạo prompt cụ thể cho video.
prompt_alpha (`float`, *tuỳ chọn*, mặc định là 0.1) : Giá trị Alpha được sử dụng trong trình tạo prompt cụ thể cho video.
prompt_hidden_act (`str` hoặc `function`, *tùy chọn*, mặc định là `"quick_gelu"`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong trình tạo prompt cụ thể cho video. Nếu là chuỗi, `"gelu"`, `"relu"`, `"selu"` và `"gelu_new"` `"quick_gelu"` được hỗ trợ.
prompt_num_attention_heads (`int`, *tuỳ chọn*, mặc định là 8) : Số lượng đầu chú ý trong cross-attention của trình tạo prompt cụ thể cho video.
prompt_attention_dropout (`float`, *tuỳ chọn*, mặc định là 0.0) : Xác suất dropout cho các lớp attention trong trình tạo prompt cụ thể cho video.
prompt_projection_dropout (`float`, *tuỳ chọn*, mặc định là 0.0) : Xác suất dropout cho các lớp chiếu trong trình tạo prompt cụ thể cho video.
logit_scale_init_value (`float`, *tuỳ chọn*, mặc định là `2.6592`) : Giá trị ban đầu của tham số *logit_scale*.
initializer_factor (`float`, *tuỳ chọn*, mặc định là `1.0`) : Hệ số để khởi tạo tất cả các ma trận trọng số (nên giữ ở mức 1, được sử dụng bên trong cho việc kiểm tra khởi tạo).
Đây là lớp cấu hình để lưu trữ cấu hình của một X ClipModel. Nó được sử dụng để khởi tạo một mô hình X Clip theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
## XCLIPTextConfig[[transformers.XCLIPTextConfig]]
#### transformers.XCLIPTextConfig[[transformers.XCLIPTextConfig]]
```python
transformers.XCLIPTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/configuration_x_clip.py#L27)
**Tham số:**
vocab_size (`int`, *tùy chọn*, mặc định là `49408`) : Kích thước từ vựng của mô hình. Xác định số lượng token khác nhau có thể được biểu diễn bởi `input_ids`.
hidden_size (`int`, *tuỳ chọn*, mặc định là `512`) : Kích thước của các biểu diễn ẩn.
intermediate_size (`int`, *tuỳ chọn*, mặc định là `2048`) : Kích thước của các biểu diễn MLP.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `12`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
num_attention_heads (`int`, *tuỳ chọn*, mặc định là `8`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
max_position_embeddings (`int`, *tuỳ chọn*, mặc định là `77`) : Độ dài tối đa của chuỗi mà mô hình này có thể được sử dụng.
hidden_act (`str`, *tùy chọn*, mặc định là `quick_gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-05`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
attention_dropout (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Tỷ lệ dropout cho các xác suất chú ý.
initializer_range (`float`, *optional*, mặc định là `0.02`) : Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số.
initializer_factor (`float`, *tuỳ chọn*, mặc định là `1.0`) : Hệ số để khởi tạo tất cả các ma trận trọng số (nên giữ ở mức 1, được sử dụng bên trong cho việc kiểm tra khởi tạo).
pad_token_id (`int`, *tuỳ chọn*, mặc định là `1`) : Id của token được sử dụng để đệm (padding) trong từ vựng.
bos_token_id (`int`, *tuỳ chọn*, mặc định là `0`) : Id của token được dùng cho đầu luồng (beginning-of-stream) trong từ vựng.
eos_token_id (`Union[int, list[int]]`, *tùy chọn*, mặc định là `2`) : Id của token được sử dụng cho end-of-stream trong bảng từ vựng.
Đây là lớp cấu hình để lưu trữ cấu hình của một X ClipModel. Nó được sử dụng để khởi tạo một mô hình X Clip theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import XCLIPTextModel, XCLIPTextConfig
>>> # Initializing a XCLIPTextModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPTextConfig()
>>> # Initializing a XCLIPTextConfig from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
#### transformers.XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
```python
transformers.XCLIPVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, mit_hidden_size: int = 512, mit_intermediate_size: int = 2048, mit_num_hidden_layers: int = 1, mit_num_attention_heads: int = 8, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 32, num_frames: int = 8, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, drop_path_rate: float | int = 0.0)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/configuration_x_clip.py#L65)
**Tham số:**
hidden_size (`int`, *optional*, mặc định là `768`) : Kích thước của các biểu diễn ẩn.
intermediate_size (`int`, *tuỳ chọn*, mặc định là `3072`) : Kích thước của các biểu diễn MLP.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `12`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
num_attention_heads (`int`, *tùy chọn*, mặc định là `12`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
mit_hidden_size (`int`, *optional*, mặc định là 512) : Độ chiều của các lớp encoder của Multiframe Integration Transformer (MIT).
mit_intermediate_size (`int`, *optional*, mặc định là 2048) : Độ chiều của lớp "trung gian" (tức là lớp feed-forward) trong Multiframe Integration Transformer (MIT).
mit_num_hidden_layers (`int`, *optional*, mặc định là 1) : Số lượng lớp ẩn trong Multiframe Integration Transformer (MIT).
mit_num_attention_heads (`int`, *tuỳ chọn*, mặc định là 8) : Số lượng đầu chú ý cho mỗi lớp chú ý trong Multiframe Integration Transformer (MIT).
num_channels (`int`, *tuỳ chọn*, mặc định là `3`) : Số lượng kênh đầu vào.
image_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `224`) : Kích thước (độ phân giải) của mỗi hình ảnh.
patch_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `32`) : Kích thước (độ phân giải) của mỗi patch.
num_frames (`int`, *tuỳ chọn*, mặc định là 8) : Số khung hình trong mỗi video.
hidden_act (`str`, *tùy chọn*, mặc định là `quick_gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-05`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
attention_dropout (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Tỷ lệ dropout cho các xác suất chú ý.
initializer_range (`float`, *optional*, mặc định là `0.02`) : Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số.
initializer_factor (`float`, *tuỳ chọn*, mặc định là `1.0`) : Hệ số để khởi tạo tất cả các ma trận trọng số (nên giữ ở mức 1, được sử dụng bên trong cho việc kiểm tra khởi tạo).
drop_path_rate (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Tỷ lệ drop path cho việc hợp nhất patch.
Đây là lớp cấu hình để lưu trữ cấu hình của một X ClipModel. Nó được sử dụng để khởi tạo một mô hình X Clip theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import XCLIPVisionModel, XCLIPVisionConfig
>>> # Initializing a XCLIPVisionModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPVisionConfig()
>>> # Initializing a XCLIPVisionModel model from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPModel[[transformers.XCLIPModel]]
#### transformers.XCLIPModel[[transformers.XCLIPModel]]
```python
transformers.XCLIPModel(config: XCLIPConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L914)
**Tham số:**
config ([XCLIPConfig](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình X Clip cơ bản, xuất ra các hidden-states thô mà không có bất kỳ head cụ thể nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.XCLIPModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L981)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng `image_processor_class`. Xem `image_processor_class.__call__` để biết chi tiết (`processor_class` sử dụng `image_processor_class` để xử lý ảnh).
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
position_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các embedding vị trí. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
return_loss (`bool`, *tùy chọn*) : Có trả về tổn thất tương phản hay không.
interpolate_pos_encoding (`bool`, *tùy chọn*, mặc định là `False`) : Có nội suy các mã hóa vị trí được huấn luyện trước hay không.
**Trả về:** `XCLIPOutput` hoặc `tuple(torch.Tensor)`
Một `XCLIPOutput` hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các thành phần khác nhau tùy thuộc vào cấu hình ([XCLIPConfig](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPConfig)) và đầu vào.
Phương thức forward của [XCLIPModel](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `return_loss` là `True`) -- Mất đối chiếu (contrastive loss) cho độ tương đồng video-văn bản.
- **logits_per_text** (`torch.Tensor` có hình dạng `(text_batch_size, video_batch_size)`) -- Điểm tích vô hướng có tỷ lệ giữa `text_embeds` và `video_embeds`. Đây đại diện cho điểm độ tương tự giữa văn bản và video.
- **text_embeds** (`torch.Tensor` có hình dạng `(batch_size, output_dim`) -- Các vector nhúng văn bản thu được bằng cách áp dụng lớp chiếu lên đầu ra đã gom (pooled output) của [XCLIPTextModel](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPTextModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *tùy chọn*) -- Đầu ra của [XCLIPTextModel](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *tùy chọn*) -- Đầu ra của [XCLIPVisionModel](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPVisionModel).
- **logits_per_video** (`torch.Tensor` có hình dạng `(video_batch_size, text_batch_size)`) -- Điểm tích vô hướng có hệ số giữa `video_embeds` và `text_embeds`. Đây là điểm độ tương tự giữa video và văn bản.
- **video_embeds** (`torch.Tensor` có hình dạng `(batch_size, output_dim`) -- Các embedding video thu được bằng cách áp dụng lớp chiếu lên đầu ra đã pool của [XCLIPVisionModel](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPVisionModel).
- **mit_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *tùy chọn*) -- Đầu ra của `XCLIPMultiframeIntegrationTransformer` (viết tắt là MIT).
Ví dụ:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(
... text=["playing sports", "eating spaghetti", "go shopping"],
... videos=list(video),
... return_tensors="pt",
... padding=True,
... )
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> logits_per_video = outputs.logits_per_video # this is the video-text similarity score
>>> probs = logits_per_video.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(probs)
tensor([[1.9496e-04, 9.9960e-01, 2.0825e-04]])
```
#### get_text_features[[transformers.XCLIPModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L946)
**Tham số:**
input_ids (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`) : Chỉ số của các token trong chuỗi đầu vào trong từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết thêm chi tiết. [Input IDs là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
**Trả về:** [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc `tuple(torch.Tensor)`
Một [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([XCLIPConfig](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPConfig)) và đầu vào.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
- **pooler_output** (`torch.Tensor` có hình dạng `(batch_size, hidden_size)`) -- Trạng thái ẩn của lớp cuối cùng cho token đầu tiên của chuỗi (token phân loại) sau khi được xử lý thêm thông qua các lớp dùng cho tác vụ tiền huấn luyện bổ trợ. Ví dụ, đối với các mô hình thuộc họ BERT, giá trị này trả về token phân loại sau khi được xử lý qua một lớp tuyến tính và một hàm kích hoạt tanh. Trọng số của lớp tuyến tính được huấn luyện từ mục tiêu dự đoán câu tiếp theo (phân loại) trong quá trình tiền huấn luyện.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> import torch
>>> from transformers import AutoTokenizer, AutoModel
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_video_features[[transformers.XCLIPModel.get_video_features]]
```python
get_video_features(pixel_values: Tensor, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L1141)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng `image_processor_class`. Xem `image_processor_class.__call__` để biết chi tiết (`processor_class` sử dụng `image_processor_class` để xử lý ảnh).
**Trả về:** [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc `tuple(torch.Tensor)`
Một [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([XCLIPConfig](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPConfig)) và đầu vào.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
- **pooler_output** (`torch.Tensor` có hình dạng `(batch_size, hidden_size)`) -- Trạng thái ẩn của lớp cuối cùng cho token đầu tiên của chuỗi (token phân loại) sau khi được xử lý thêm thông qua các lớp dùng cho tác vụ tiền huấn luyện bổ trợ. Ví dụ, đối với các mô hình thuộc họ BERT, giá trị này trả về token phân loại sau khi được xử lý qua một lớp tuyến tính và một hàm kích hoạt tanh. Trọng số của lớp tuyến tính được huấn luyện từ mục tiêu dự đoán câu tiếp theo (phân loại) trong quá trình tiền huấn luyện.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(videos=list(video), return_tensors="pt")
>>> video_features = model.get_video_features(**inputs)
```
## XCLIPTextModel[[transformers.XCLIPTextModel]]
#### transformers.XCLIPTextModel[[transformers.XCLIPTextModel]]
```python
transformers.XCLIPTextModel(config: XCLIPTextConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L549)
**Tham số:**
config ([XCLIPTextConfig](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPTextConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình văn bản từ XCLIP không có bất kỳ đầu (head) hay phép chiếu (projection) nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.XCLIPTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L563)
**Tham số:**
input_ids (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết thêm chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
**Trả về:** [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc `tuple(torch.Tensor)`
Một [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([XCLIPConfig](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPConfig)) và đầu vào.
Phương thức forward của [XCLIPTextModel](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPTextModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
- **pooler_output** (`torch.Tensor` có hình dạng `(batch_size, hidden_size)`) -- Trạng thái ẩn của lớp cuối cùng cho token đầu tiên của chuỗi (token phân loại) sau khi được xử lý thêm thông qua các lớp dùng cho tác vụ tiền huấn luyện bổ trợ. Ví dụ, đối với các mô hình thuộc họ BERT, giá trị này trả về token phân loại sau khi được xử lý qua một lớp tuyến tính và một hàm kích hoạt tanh. Trọng số của lớp tuyến tính được huấn luyện từ mục tiêu dự đoán câu tiếp theo (phân loại) trong quá trình tiền huấn luyện.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoTokenizer, XCLIPTextModel
>>> model = XCLIPTextModel.from_pretrained("microsoft/xclip-base-patch32")
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## XCLIPVisionModel[[transformers.XCLIPVisionModel]]
#### transformers.XCLIPVisionModel[[transformers.XCLIPVisionModel]]
```python
transformers.XCLIPVisionModel(config: XCLIPVisionConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L647)
**Tham số:**
config ([XCLIPVisionConfig](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPVisionConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình thị giác từ XCLIP không có bất kỳ đầu (head) hay phép chiếu (projection) nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.XCLIPVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/x_clip/modeling_x_clip.py#L663)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng `image_processor_class`. Xem `image_processor_class.__call__` để biết chi tiết (`processor_class` sử dụng `image_processor_class` để xử lý ảnh).
interpolate_pos_encoding (`bool`, *tùy chọn*, mặc định là `False`) : Có nội suy các mã hóa vị trí được huấn luyện trước hay không.
**Trả về:** [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc `tuple(torch.Tensor)`
Một [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([XCLIPConfig](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPConfig)) và đầu vào.
Phương thức forward của [XCLIPVisionModel](/docs/transformers/main/vi/model_doc/xclip#transformers.XCLIPVisionModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
- **pooler_output** (`torch.Tensor` có hình dạng `(batch_size, hidden_size)`) -- Trạng thái ẩn của lớp cuối cùng cho token đầu tiên của chuỗi (token phân loại) sau khi được xử lý thêm thông qua các lớp dùng cho tác vụ tiền huấn luyện bổ trợ. Ví dụ, đối với các mô hình thuộc họ BERT, giá trị này trả về token phân loại sau khi được xử lý qua một lớp tuyến tính và một hàm kích hoạt tanh. Trọng số của lớp tuyến tính được huấn luyện từ mục tiêu dự đoán câu tiếp theo (phân loại) trong quá trình tiền huấn luyện.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, XCLIPVisionModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 16 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = XCLIPVisionModel.from_pretrained("microsoft/xclip-base-patch32")
>>> pixel_values = processor(videos=list(video), return_tensors="pt").pixel_values
>>> batch_size, num_frames, num_channels, height, width = pixel_values.shape
>>> pixel_values = pixel_values.reshape(-1, num_channels, height, width)
>>> outputs = model(pixel_values)
>>> last_hidden_state = outputs.last_hidden_state
```