# BridgeTower
## 概要
BridgeTowerモデルは、Xiao Xu、Chenfei Wu、Shachar Rosenman、Vasudev Lal、Wanxiang Che、Nan Duan による [BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning](https://huggingface.co/papers/2206.08657) で提案されました。このモデルの目的は、各単一モーダルエンコーダーとクロスモーダルエンコーダーの間にブリッジを構築し、クロスモーダルエンコーダーの各層で包括的かつ詳細な相互作用を可能にすることです。これにより、追加の性能および計算コストをほぼ無視できるレベルに抑えながら、さまざまな下流タスクで優れた性能を実現します。
本論文は[AAAI'23](https://aaai.org/Conferences/AAAI-23/)会議に採択されました。
論文の抄録は以下の通りです。
*近年、TWO-TOWER アーキテクチャを持つ Vision-Language (VL) モデルが、視覚言語表現学習の分野を主導しています。現在の VL モデルは、軽量な単一モーダルエンコーダを使用し、深いクロスモーダルエンコーダ内で両方のモーダルを同時に抽出・アラインメント・融合するよう学習するか、深い事前学習済み単一モーダルエンコーダの最終層の単一モーダル表現を、上位のクロスモーダルエンコーダに投入するかのいずれかのアプローチを採用しています。どちらのアプローチも、視覚言語表現学習を潜在的に制限し、モデルの性能を制約する可能性があります。本論文では、BRIDGETOWER を提案します。BRIDGETOWER は、単一モーダルエンコーダの上位層とクロスモーダルエンコーダの各層との間に接続を構築する複数のブリッジ層を導入します。これにより、クロスモーダルエンコーダ内で、事前学習済み単一モーダルエンコーダの異なる意味レベルの視覚表現とテキスト表現の間で、効果的なボトムアップ型のクロスモーダルアラインメントと融合が可能になります。わずか 400 万枚の画像のみで事前学習を行った BRIDGETOWER は、さまざまな下流の視覚言語タスクで最先端の性能を達成しています。特に、VQAv2 の test-std セットにおいて、BRIDGETOWER は 78.73% の精度を達成し、同じ事前学習データを使用しながら、ほぼ無視できるほどの追加パラメータと計算コストで、従来の最先端モデル METER を 1.09% 上回っています。さらに注目すべきは、モデルをさらにスケールアップさせた場合、BRIDGETOWER は 81.15% の精度を達成し、桁違いに大きなデータセットで事前学習されたモデルを凌駕する点です。*
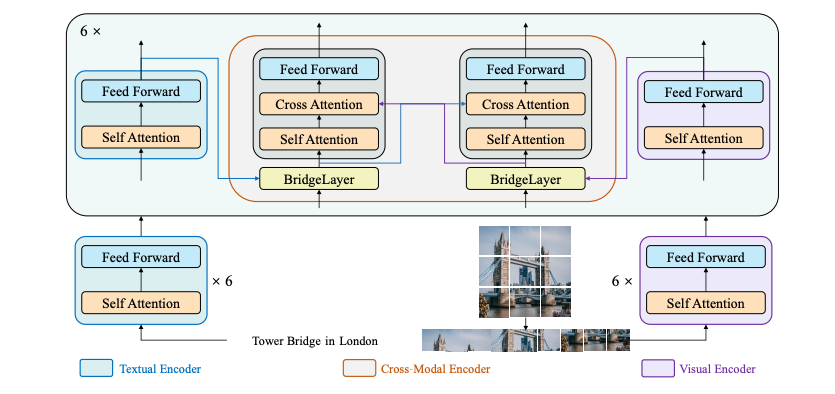 BridgeTowerアーキテクチャ。元の論文より引用。
このモデルは、[Anahita Bhiwandiwalla](https://huggingface.co/anahita-b)、[Tiep Le](https://huggingface.co/Tile)、[Shaoyen Tseng](https://huggingface.co/shaoyent) によって提供されました。元のコードは[こちら](https://github.com/microsoft/BridgeTower)で確認できます。
## 使用のコツと例
BridgeTowerは、ビジュアルエンコーダー、テキストエンコーダー、および複数の軽量なブリッジ層を備えたクロスモーダルエンコーダーで構成されています。このアプローチの目的は、各ユニモーダルエンコーダーとクロスモーダルエンコーダーの間にブリッジを構築し、クロスモーダルエンコーダーの各層で包括的かつ詳細な相互作用を可能にすることです。原理的には、提案されたアーキテクチャにおいて、任意のビジュアル、テキスト、またはクロスモーダルエンコーダーを適用できます。
[BridgeTowerProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerProcessor) は、[RobertaTokenizer](/docs/transformers/v5.23.0/ja/model_doc/led#transformers.RobertaTokenizer) と [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) を単一のインスタンスにまとめ、それぞれテキストのエンコードと画像の準備を行います。
以下の例では、[BridgeTowerProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerProcessor)と[BridgeTowerForContrastiveLearning](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning)を使用して対照的学習を実行する方法を示します。
```python
import requests
from PIL import Image
from transformers import BridgeTowerForContrastiveLearning, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs
```
次の例では、[BridgeTowerProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerProcessor)と[BridgeTowerForImageAndTextRetrieval](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval)を使用して画像とテキストの検索を実行する方法を示します。
```python
import requests
from PIL import Image
from transformers import BridgeTowerForImageAndTextRetrieval, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs.logits[0, 1].item()
```
以下の例では、[BridgeTowerProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerProcessor)と[BridgeTowerForMaskedLM](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM)を使用してマスク言語モデリングを実行する方法を示します。
```python
from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
from PIL import Image
import requests
url = "http://images.cocodataset.org/val2017/000000360943.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
text = "a looking out of the window"
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
# forward pass
outputs = model(**encoding)
results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
print(results)
.a cat looking out of the window.
```
ヒント:
- この BridgeTower の実装では、テキスト埋め込みの生成に [RobertaTokenizer](/docs/transformers/v5.23.0/ja/model_doc/led#transformers.RobertaTokenizer) を、視覚埋め込みの計算には OpenAI の CLIP/ViT モデルを使用しています。
- 事前学習済み[bridgeTower-base](https://huggingface.co/BridgeTower/bridgetower-base)および[bridgetower masked language modeling and image text matching](https://huggingface.co/BridgeTower/bridgetower-base-itm-mlm)のチェックポイントが公開されました。
- BridgeTowerのImage Retrievalおよびその他の下流タスクにおける性能については、[Table 5](https://huggingface.co/papers/2206.08657)を参照してください。
## BridgeTowerConfig[[transformers.BridgeTowerConfig]]
#### transformers.BridgeTowerConfig[[transformers.BridgeTowerConfig]]
```python
transformers.BridgeTowerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, share_cross_modal_transformer_layers: bool = True, hidden_act: str = 'gelu', hidden_size: int = 768, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, share_link_tower_layers: bool = False, link_tower_type: str = 'add', num_attention_heads: int = 12, num_hidden_layers: int = 6, tie_word_embeddings: bool = False, init_layernorm_from_vision_encoder: bool = False, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/configuration_bridgetower.py#L104)
**パラメータ:**
share_cross_modal_transformer_layers (`bool`、*任意*、デフォルトは `True`) : クロスモーダル Transformer レイヤーが共有されるかどうか。
hidden_act (`str`、*任意*、デフォルトは`gelu`) : デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、`"gelu"`、`"relu"`、`"silu"`など。
hidden_size (`int`、*任意*、デフォルトは`768`) : 隠れ表現の次元数。
initializer_factor (`Union[float, int]`、*任意*、デフォルトは `1`) : 全重み行列の初期化に用いる係数です(1 に保つ必要があります。初期化のテスト用に内部で使用されます)。
layer_norm_eps (`float`、*任意*、デフォルトは`1e-05`) : Layer Normalization 層で使用する epsilon。
share_link_tower_layers (`bool`、*任意*、デフォルトは `False`) : ブリッジ/リンクのタワー層が共有されるかどうかを示します。
link_tower_type (`str`、*任意*、デフォルトは`"add"`) : ブリッジ/リンク層のタイプ。
num_attention_heads (`int`、*任意*、デフォルトは `12`) : Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。
num_hidden_layers (`int`、*任意*、デフォルトは`6`) : Transformer デコーダーの隠れ層の数。
tie_word_embeddings (`bool`, *任意*, デフォルトは `False`) : モデルの `tied_weights_keys` マッピングに従って重み埋め込みを共有するかどうか。
init_layernorm_from_vision_encoder (`bool`、*任意*、デフォルトは `False`) : ビジョンエンコーダーから LayerNorm を初期化するか否か。
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *任意*) : テキストバックボーンの config オブジェクトまたは辞書。
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *任意*) : ビジョンバックボーンの config オブジェクトまたは辞書。
これは、BridgeTowerModel の設定を保存するための設定クラスです。指定された引数に基づいて Bridgetower モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base) と同様の設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import BridgeTowerModel, BridgeTowerConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration
>>> configuration = BridgeTowerConfig()
>>> # Initializing a model from the BridgeTower/bridgetower-base style configuration
>>> model = BridgeTowerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
#### transformers.BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
```python
transformers.BridgeTowerTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, initializer_factor: float | int = 1, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 514, type_vocab_size: int = 1, layer_norm_eps: float = 1e-05, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, use_cache: bool = True, is_decoder: bool = False, add_cross_attention: bool = False)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/configuration_bridgetower.py#L65)
**パラメータ:**
vocab_size (`int`、*任意*、デフォルトは`50265`) : モデルの語彙サイズ。`input_ids`で表現できるトークンの種類数を定義します。
hidden_size (`int`、*任意*、デフォルトは`768`) : 隠れ表現の次元数。
num_hidden_layers (`int`, *任意*, デフォルトは `12`) : Transformer デコーダーの隠れ層の数。
num_attention_heads (`int`、*任意*、デフォルトは `12`) : Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。
initializer_factor (`Union[float, int]`、*任意*、デフォルトは `1`) : 全重み行列の初期化に用いる係数です(1 に保つ必要があります。初期化のテスト用に内部で使用されます)。
intermediate_size (`int`、*任意*、デフォルトは `3072`) : MLP 表現の次元数。
hidden_act (`str`、*任意*、デフォルトは`gelu`) : デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、`"gelu"`、`"relu"`、`"silu"`など。
hidden_dropout_prob (`Union[float, int]`、*任意*、デフォルト値は`0.1`) : embeddings、encoder、pooler 内のすべての全結合層における dropout 確率。
attention_probs_dropout_prob (`Union[float, int]`、*任意*、デフォルトは`0.1`) : 注意確率のドロップアウト率。
max_position_embeddings (`int`、*任意*、デフォルトは`514`) : このモデルが使用される可能性のある最大シーケンス長。
type_vocab_size (`int`、*任意*、デフォルトは`1`) : `token_type_ids`の語彙サイズ。
layer_norm_eps (`float`、*任意*、デフォルトは`1e-05`) : Layer Normalization 層で使用する epsilon。
pad_token_id (`int`, *任意*, デフォルトは `1`) : 語彙内でパディングに使用されるトークン ID。
bos_token_id (`int`, *optional*, デフォルトは `0`) : 語彙内でストリームの開始に使用されるトークン ID。
eos_token_id (`Union[int, list[int]]`、*任意*、デフォルトは`2`) : 語彙内でストリーム終了に使用されるトークン ID。
use_cache (`bool`、*任意*、デフォルトは `True`) : モデルが最後のキー/バリューアテンションを返すかどうか(すべてのモデルで利用されるわけではありません)。`config.is_decoder=True` の場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。
is_decoder (`bool`, *任意*, デフォルトは `False`) : モデルがデコーダーとして使用されるかどうかを指定します。`False` の場合、モデルはエンコーダーとして使用されます。
add_cross_attention (`bool`、*任意*、デフォルトは`False`) : モデルにクロスアテンション層を追加するかどうか。
これは、BridgeTowerModel の設定を保存するための設定クラスです。指定された引数に基づいて Bridgetower モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base) と同様の設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import BridgeTowerTextConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the text model
>>> configuration = BridgeTowerTextConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
#### transformers.BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
```python
transformers.BridgeTowerVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 16, image_size: int | list[int] | tuple[int, int] = 288, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, stop_gradient: bool = False, share_layernorm: bool = True, remove_last_layer: bool = False)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/configuration_bridgetower.py#L27)
**パラメータ:**
hidden_size (`int`、*任意*、デフォルトは`768`) : 隠れ表現の次元数。
num_hidden_layers (`int`, *任意*, デフォルトは `12`) : Transformer デコーダーの隠れ層の数。
num_channels (`int`、*任意*、デフォルトは`3`) : 入力チャネル数。
patch_size (`Union[int, list[int], tuple[int, int]]`、*任意*、デフォルトは`16`) : 各パッチのサイズ(解像度)。
image_size (`Union[int, list[int], tuple[int, int]]`、*任意*、デフォルトは`288`) : 各画像のサイズ(解像度)。
initializer_factor (`Union[float, int]`、*任意*、デフォルトは `1`) : 全重み行列の初期化に用いる係数です(1 に保つ必要があります。初期化のテスト用に内部で使用されます)。
layer_norm_eps (`float`、*任意*、デフォルトは`1e-05`) : Layer Normalization 層で使用する epsilon。
stop_gradient (`bool`、*任意*、デフォルトは`False`) : 学習時の勾配を停止するかどうか。
share_layernorm (`bool`、*任意*、デフォルトは`True`) : LayerNorm 層が共有されるかどうか。
remove_last_layer (`bool`、*任意*、デフォルトは`False`) : ビジョンエンコーダーから最後の層を削除するかどうか。
これは、BridgeTowerModel の設定を保存するための設定クラスです。指定された引数に基づいて Bridgetower モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base) と同様の設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/v5.23.0/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import BridgeTowerVisionConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the vision model
>>> configuration = BridgeTowerVisionConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
#### transformers.BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
```python
transformers.BridgeTowerImageProcessor(**kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/image_processing_bridgetower.py#L76)
**パラメータ:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *任意*, デフォルトは `True`) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は `{'shortest_edge' : 288}`): モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*, デフォルトは `False`) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は `{'shortest_edge' : 288}`): `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*、デフォルトは `3`) : 画像をリサイズする場合に使用するリサンプリングフィルター。`PILImageResampling` の列挙型のいずれかになります。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*, デフォルトは `0.00392156862745098`) : `do_rescale` が `True` に設定されている場合、画像をリスケールするための係数。
do_normalize (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.48145466, 0.4578275, 0.40821073]`) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.26862954, 0.26130258, 0.27577711]`) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
size_divisor (`int`, *kwargs*、デフォルトは `32`) : 高さと幅の両方が割り切れることを保証するためのサイズです。
BridgeTowerImageProcessor の画像プロセッサを構築します。
#### preprocess[[transformers.BridgeTowerImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 前処理対象の画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
image_like_kwargs (`dict[str, Any]`、*省略可*) : 追加の画像類似の入力も前処理対象にするための開発者向けフラグです。引数として kwarg を渡す方法が機能しない場合のみ使用してください。例えば、`preprocess(images, masks=masks)` が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりに `preprocess(images, image_like_inputs={"masks": masks})` を使用できます。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *optional*) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 画像をリサイズする場合に使用するリサンプリングフィルタ。`PILImageResampling` の列挙型のいずれかです。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *任意*) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*) : `do_rescale` が `True` に設定されている場合、画像をリサイズするためのリスケール係数。
do_normalize (`bool`, *kwargs*, *optional*) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
**戻り値:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ メソッドによって返されるリスト/配列/テンソルの辞書('pixel_values' など)。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
## BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
#### transformers.BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
```python
transformers.BridgeTowerImageProcessorPil(**kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/image_processing_pil_bridgetower.py#L70)
**パラメータ:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *任意*, デフォルトは `True`) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は `{'shortest_edge' : 288}`): モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*, デフォルトは `False`) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は `{'shortest_edge' : 288}`): `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*、デフォルトは `3`) : 画像をリサイズする場合に使用するリサンプリングフィルター。`PILImageResampling` の列挙型のいずれかになります。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*, デフォルトは `0.00392156862745098`) : `do_rescale` が `True` に設定されている場合、画像をリスケールするための係数。
do_normalize (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.48145466, 0.4578275, 0.40821073]`) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.26862954, 0.26130258, 0.27577711]`) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
size_divisor (`int`, *kwargs*、デフォルトは `32`) : 高さと幅の両方が割り切れることを保証するためのサイズです。
BridgeTowerImageProcessor の画像プロセッサを構築します。
#### preprocess[[transformers.BridgeTowerImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 前処理対象の画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
image_like_kwargs (`dict[str, Any]`、*省略可*) : 追加の画像類似の入力も前処理対象にするための開発者向けフラグです。引数として kwarg を渡す方法が機能しない場合のみ使用してください。例えば、`preprocess(images, masks=masks)` が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりに `preprocess(images, image_like_inputs={"masks": masks})` を使用できます。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *optional*) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 画像をリサイズする場合に使用するリサンプリングフィルタ。`PILImageResampling` の列挙型のいずれかです。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *任意*) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*) : `do_rescale` が `True` に設定されている場合、画像をリサイズするためのリスケール係数。
do_normalize (`bool`, *kwargs*, *optional*) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
**戻り値:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ メソッドによって返されるリスト/配列/テンソルの辞書('pixel_values' など)。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
## BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
#### transformers.BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
```python
transformers.BridgeTowerProcessor(image_processor, tokenizer)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/processing_bridgetower.py#L24)
**パラメータ:**
image_processor (`BridgeTowerImageProcessor`) : 画像プロセッサは必須の入力です。
tokenizer (`RobertaTokenizer`) : トークナイザーは必須の入力です。
画像プロセッサとトークナイザーを単一のプロセッサにラップするBridgeTowerProcessorを構築します。
[BridgeTowerProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerProcessor) は、[BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) と [RobertaTokenizer](/docs/transformers/v5.23.0/ja/model_doc/led#transformers.RobertaTokenizer) のすべての機能を提供します。詳細については、[~BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) および [~RobertaTokenizer](/docs/transformers/v5.23.0/ja/model_doc/led#transformers.RobertaTokenizer) を参照してください。
#### __call__[[transformers.BridgeTowerProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *任意*) : 前処理を行う画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
text (`Union[str, list[str], list[list[str]]]`、*任意*) : エンコード対象のシーケンスまたはシーケンスのバッチです。各シーケンスは文字列、または文字列のリスト(プレトークナイズ済み文字列)であることができます。プレトークナイズ済み入力を渡す場合は、バッチ入力との曖昧さを避けるために `is_split_into_words=True` を設定してください。
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *任意*) : 前処理対象の動画。ピクセル値が 0 から 255 の範囲にある単一の動画またはバッチを想定しています。ピクセル値が 0 から 1 の範囲にある動画を渡す場合は、`do_rescale=False` を設定してください。
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *任意*) : 準備対象のオーディオまたはオーディオのバッチです。各オーディオは NumPy 配列または PyTorch テンソルであることができます。NumPy 配列/PyTorch テンソルの場合、各オーディオの形状は (C, T) である必要があります。ここで C はチャネル数、T はオーディオのサンプル長を表します。
return_mm_token_type_ids (`bool`, *kwargs*) : マルチモーダルプレースホルダトークンの位置を示すマルチモーダルトークンタイプIDを返すかどうか。
return_text_replacement_offsets (`bool`, *kwargs*) : 各マルチモーダルプレースホルダーとその置換文字列の文字オフセットを返すかどうか。
return_tensors (`str` または [TensorType](/docs/transformers/v5.23.0/ja/internal/file_utils#transformers.TensorType)、*optional*) : 設定されている場合、特定のフレームワークのテンソルを返します。受け入れ可能な値は以下の通りです: - `'pt'`: PyTorch の `torch.Tensor` オブジェクトを返します。 - `'np'`: NumPy の `np.ndarray` オブジェクトを返します。
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ja/main_classes/processors#transformers.ProcessingKwargs), *optional*) : 各モダリティ(テキスト、画像、動画、音声)の追加処理オプション。モデル固有のパラメータは上記にリストされています。サポートされている引数の完全なリストについては、TypedDict クラスを参照してください。
## BridgeTowerModel[[transformers.BridgeTowerModel]]
#### transformers.BridgeTowerModel[[transformers.BridgeTowerModel]]
```python
transformers.BridgeTowerModel(config: BridgeTowerConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1079)
**パラメータ:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
特定のヘッドを付加せずに、BridgeTowerModelOutput オブジェクトを出力する、素の BridgeTower Model
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.BridgeTowerModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1152)
**パラメータ:**
input_ids (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`、*任意*) : 入力画像に対応するテンソルです。ピクセル値は [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) を使用して取得できます。詳細は [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([BridgeTowerProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerProcessor) は画像の処理に [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) を使用します)。
pixel_mask (`torch.LongTensor`、形状 `(batch_size, height, width)`、*任意*) : パディングピクセル値に対するアテンションの実行を回避するためのマスク。`[0, 1]` から選択されるマスク値: - 実在するピクセル(つまり **マスクされていない**)は 1、 - パディングのピクセル(つまり **マスクされている**)は 0。 [アテンションマスクとは何ですか?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
image_embeds (`torch.Tensor`、shape `(batch_size, num_patches, hidden_size)`、*optional*) : `pixel_values`を渡す代わりに、埋め込み表現を直接渡すこともできます。`pixel_values`をパッチ埋め込みに変換する方法をより細かく制御したい場合に便利です。
image_token_type_idx (`int`, *任意*) : - 画像のトークンタイプID。
labels (`torch.LongTensor`、形状 `(batch_size,)`、*任意*) : ラベルは現在サポートされていません。
interpolate_pos_encoding (`bool`、*任意*、デフォルトは`False`) : 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
**戻り値:** `BridgeTowerModelOutput` または `tuple(torch.Tensor)`
`BridgeTowerModelOutput`、または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。設定([BridgeTowerConfig](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerConfig))と入力に応じて、さまざまな要素で構成されます。
[BridgeTowerModel](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerModel)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **text_features** (`torch.Tensor`、形状 `(batch_size, text_sequence_length, hidden_size)`) -- モデルの最終層のテキスト出力における隠れ状態のシーケンス。
- **image_features** (`torch.Tensor`、形状 `(batch_size, image_sequence_length, hidden_size)`) -- モデルの最終層の画像出力における隠れ状態のシーケンス。
- **pooler_output** (`torch.Tensor`、形状 `(batch_size, hidden_size x 2)`) -- テキストと画像シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態を、それぞれ補助的な事前学習タスクに使用される層でさらに処理した後の連結です。
- **hidden_states** (`tuple[torch.Tensor]`、*optional*、`output_hidden_states=True` が渡された場合、または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple[torch.Tensor]`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base")
>>> model = BridgeTowerModel.from_pretrained("BridgeTower/bridgetower-base")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> outputs.keys()
odict_keys(['text_features', 'image_features', 'pooler_output'])
```
## BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
#### transformers.BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
```python
transformers.BridgeTowerForContrastiveLearning(config: BridgeTowerConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1603)
**パラメータ:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
BridgeTowerモデルは、画像とテキストの対比損失を計算する画像・テキスト対比ヘッドを上部に備えています。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.BridgeTowerForContrastiveLearning.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1617)
**パラメータ:**
input_ids (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`、*任意*) : 入力画像に対応するテンソルです。ピクセル値は [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) を使用して取得できます。詳細は [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([BridgeTowerProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerProcessor) は画像の処理に [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) を使用します)。
pixel_mask (`torch.LongTensor`、形状 `(batch_size, height, width)`、*任意*) : パディングピクセル値に対するアテンションの実行を回避するためのマスク。`[0, 1]` から選択されるマスク値: - 実在するピクセル(つまり **マスクされていない**)は 1、 - パディングのピクセル(つまり **マスクされている**)は 0。 [アテンションマスクとは何ですか?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
image_embeds (`torch.Tensor`、shape `(batch_size, num_patches, hidden_size)`、*optional*) : `pixel_values`を渡す代わりに、埋め込み表現を直接渡すこともできます。`pixel_values`をパッチ埋め込みに変換する方法をより細かく制御したい場合に便利です。
return_loss (`bool`, *任意*) : 対比損失を返すかどうか。
**戻り値:** `BridgeTowerContrastiveOutput` または `tuple(torch.Tensor)`
`BridgeTowerContrastiveOutput` または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。[BridgeTowerConfig](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerConfig) および入力に応じて、さまざまな要素で構成されます。
[BridgeTowerForContrastiveLearning](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning) の forward メソッドは、`__call__` という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、shape `(1,)`、*optional*、`return_loss` が `True` の場合のみ返されます) -- 画像とテキストの対照的損失。
- **logits** (`torch.Tensor`、形状 `(batch_size, sequence_length, config.vocab_size)`) -- 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。
- **text_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The text embeddings obtained by applying the projection layer to the pooler_output.
- **image_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The image embeddings obtained by applying the projection layer to the pooler_output.
- **cross_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The text-image cross-modal embeddings obtained by applying the projection layer to the pooler_output.
- **hidden_states** (`tuple[torch.Tensor]`、*optional*、`output_hidden_states=True` が渡された場合、または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
例:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForContrastiveLearning
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> image_urls = [
... "https://farm4.staticflickr.com/3395/3428278415_81c3e27f15_z.jpg",
... "http://images.cocodataset.org/val2017/000000039769.jpg",
... ]
>>> texts = ["two dogs in a car", "two cats sleeping on a couch"]
>>> with httpx.stream("GET", urls[0]) as response:
... image1 = Image.open(BytesIO(response.read()))
>>> with httpx.stream("GET", urls[1]) as response:
... image2 = Image.open(BytesIO(response.read()))
>>> images = [image1, image2]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> inputs = processor(images, texts, padding=True, return_tensors="pt")
>>> loss = model(**inputs, return_loss=True).loss
>>> inputs = processor(images, texts[::-1], padding=True, return_tensors="pt")
>>> loss_swapped = model(**inputs, return_loss=True).loss
>>> print("Loss", round(loss.item(), 4))
Loss 0.0019
>>> print("Loss with swapped images", round(loss_swapped.item(), 4))
Loss with swapped images 2.126
```
## BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
#### transformers.BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
```python
transformers.BridgeTowerForMaskedLM(config: BridgeTowerConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1404)
**パラメータ:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
BridgeTowerモデルに、事前学習時に使用した言語モデリングヘッドを上に配置したものです。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.BridgeTowerForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1422)
**パラメータ:**
input_ids (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`、*任意*) : 入力画像に対応するテンソルです。ピクセル値は [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) を使用して取得できます。詳細は [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([BridgeTowerProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerProcessor) は画像の処理に [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) を使用します)。
pixel_mask (`torch.LongTensor`、形状 `(batch_size, height, width)`、*任意*) : パディングピクセル値に対するアテンションの実行を回避するためのマスク。`[0, 1]` から選択されるマスク値: - 実在するピクセル(つまり **マスクされていない**)は 1、 - パディングのピクセル(つまり **マスクされている**)は 0。 [アテンションマスクとは何ですか?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
image_embeds (`torch.Tensor`、shape `(batch_size, num_patches, hidden_size)`、*optional*) : `pixel_values`を渡す代わりに、埋め込み表現を直接渡すこともできます。`pixel_values`をパッチ埋め込みに変換する方法をより細かく制御したい場合に便利です。
labels (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*optional*) : マスク付き言語モデリング損失を計算するためのラベル。インデックスは `[-100, 0, ..., config.vocab_size]` の範囲である必要があります(`input_ids` の docstring を参照)。インデックスが `-100` に設定されたトークンは無視(マスク)され、損失は `[0, ..., config.vocab_size]` の範囲のラベルを持つトークンに対してのみ計算されます。
**戻り値:** [MaskedLMOutput](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) または `tuple(torch.Tensor)`
設定([BridgeTowerConfig](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerConfig))と入力に応じて、さまざまな要素で構成される、[MaskedLMOutput](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.MaskedLMOutput)または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。
[BridgeTowerForMaskedLM](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM) の forward メソッドは、`__call__` という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、形状 `(1,)`、*任意*、`labels` が指定された場合に返されます) -- マスクド言語モデリング (MLM) の損失。
- **logits** (`torch.Tensor`、形状 `(batch_size, sequence_length, config.vocab_size)`) -- 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000360943.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> text = "a looking out of the window"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
>>> print(results)
.a cat looking out of the window.
```
## BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
#### transformers.BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
```python
transformers.BridgeTowerForImageAndTextRetrieval(config: BridgeTowerConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1501)
**パラメータ:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
BridgeTower Model は、画像とテキストのマッチング用に、[CLS] トークンの最終隠れ状態の上に線形層を配置した分類ヘッドを備えた transformer です。
このモデルは [PreTrainedModel](/docs/transformers/v5.23.0/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.BridgeTowerForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1512)
**パラメータ:**
input_ids (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/v5.23.0/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : 入力の前半と後半を示すセグメントトークンインデックス。インデックスは `[0, 1]` から選択されます: - 0 は *文 A* のトークンに対応します。 - 1 は *文 B* のトークンに対応します。 [トークンタイプIDとは何ですか?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`、*任意*) : 入力画像に対応するテンソルです。ピクセル値は [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) を使用して取得できます。詳細は [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください([BridgeTowerProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerProcessor) は画像の処理に [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) を使用します)。
pixel_mask (`torch.LongTensor`、形状 `(batch_size, height, width)`、*任意*) : パディングピクセル値に対するアテンションの実行を回避するためのマスク。`[0, 1]` から選択されるマスク値: - 実在するピクセル(つまり **マスクされていない**)は 1、 - パディングのピクセル(つまり **マスクされている**)は 0。 [アテンションマスクとは何ですか?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
image_embeds (`torch.Tensor`、shape `(batch_size, num_patches, hidden_size)`、*optional*) : `pixel_values`を渡す代わりに、埋め込み表現を直接渡すこともできます。`pixel_values`をパッチ埋め込みに変換する方法をより細かく制御したい場合に便利です。
labels (`torch.LongTensor`、shape `(batch_size, 1)`、*任意*) : 画像とテキストのマッチング損失を計算するためのラベル。0 はペアが一致しないことを示し、1 は一致することを示します。0 のペアは計算からスキップされます。
**戻り値:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) または `tuple(torch.Tensor)`
設定([BridgeTowerConfig](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerConfig))と入力に応じて、さまざまな要素で構成される、[SequenceClassifierOutput](/docs/transformers/v5.23.0/ja/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput)または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。
[BridgeTowerForImageAndTextRetrieval](/docs/transformers/v5.23.0/ja/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、shape `(1,)`、*optional*、`labels` が指定された場合に返されます) -- 分類損失(config.num_labels==1 の場合は回帰損失)。
- **logits** (`torch.Tensor`、形状 `(batch_size, config.num_labels)`) -- SoftMax 適用前の分類(または config.num_labels==1 の場合は回帰)スコア。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, 1].item()
```