# OWL-ViT
## Genel Bakış
OWL-ViT (Open-World Localization için Vision Transformer'ın kısaltması), Matthias Minderer, Alexey Gritsenko, Austin Stone, Maxim Neumann, Dirk Weissenborn, Alexey Dosovitskiy, Aravindh Mahendran, Anurag Arnab, Mostafa Dehghani, Zhuoran Shen, Xiao Wang, Xiaohua Zhai, Thomas Kipf ve Neil Houlsby tarafından [Simple Open-Vocabulary Object Detection with Vision Transformers](https://huggingface.co/papers/2205.06230) makalesinde önerilmiştir. OWL-ViT, çeşitli (görsel, metin) çiftleri üzerinde eğitilmiş bir açık sözlük nesne algılama ağıdır. Metinde tanımlanan hedef nesneleri aramak ve algılamak için bir görseli tek veya birden fazla metin sorgusuyla sorgulamak amacıyla kullanılabilir.
Makalenin özeti aşağıdaki gibidir:
*Sade mimarilerin büyük ölçekli ön eğitimiyle birleştirilmesi, görüntü sınıflandırmada büyük iyileşmelere yol açmıştır. Nesne algılama için ön eğitim ve ölçeklendirme yaklaşımları, eğitim verisinin nispeten az olduğu uzun kuyruklu ve açık sözlük ayarlarında daha az yerleşiktir. Bu makalede, görüntü-metin modellerini açık sözlük nesne algılamaya aktarmak için güçlü bir tarif öneriyoruz. Minimal değişikliklerle standart bir Vision Transformer mimarisi, kontrastif görüntü-metin ön eğitimi ve uçtan uca algılama ince ayarı kullanıyoruz. Bu kurulumun ölçeklenme özelliklerine ilişkin analizimiz, görüntü düzeyinde ön eğitimin ve model boyutunun artırılmasının, aşağı akış algılama görevinde tutarlı iyileşmeler sağladığını göstermektedir. Sıfır atış metin koşullu ve tek atış görüntü koşullu nesne algılamada çok güçlü performans elde etmek için gerekli adaptasyon stratejilerini ve düzenlemeleri sunuyoruz. Kod ve modeller GitHub'da mevcuttur.*
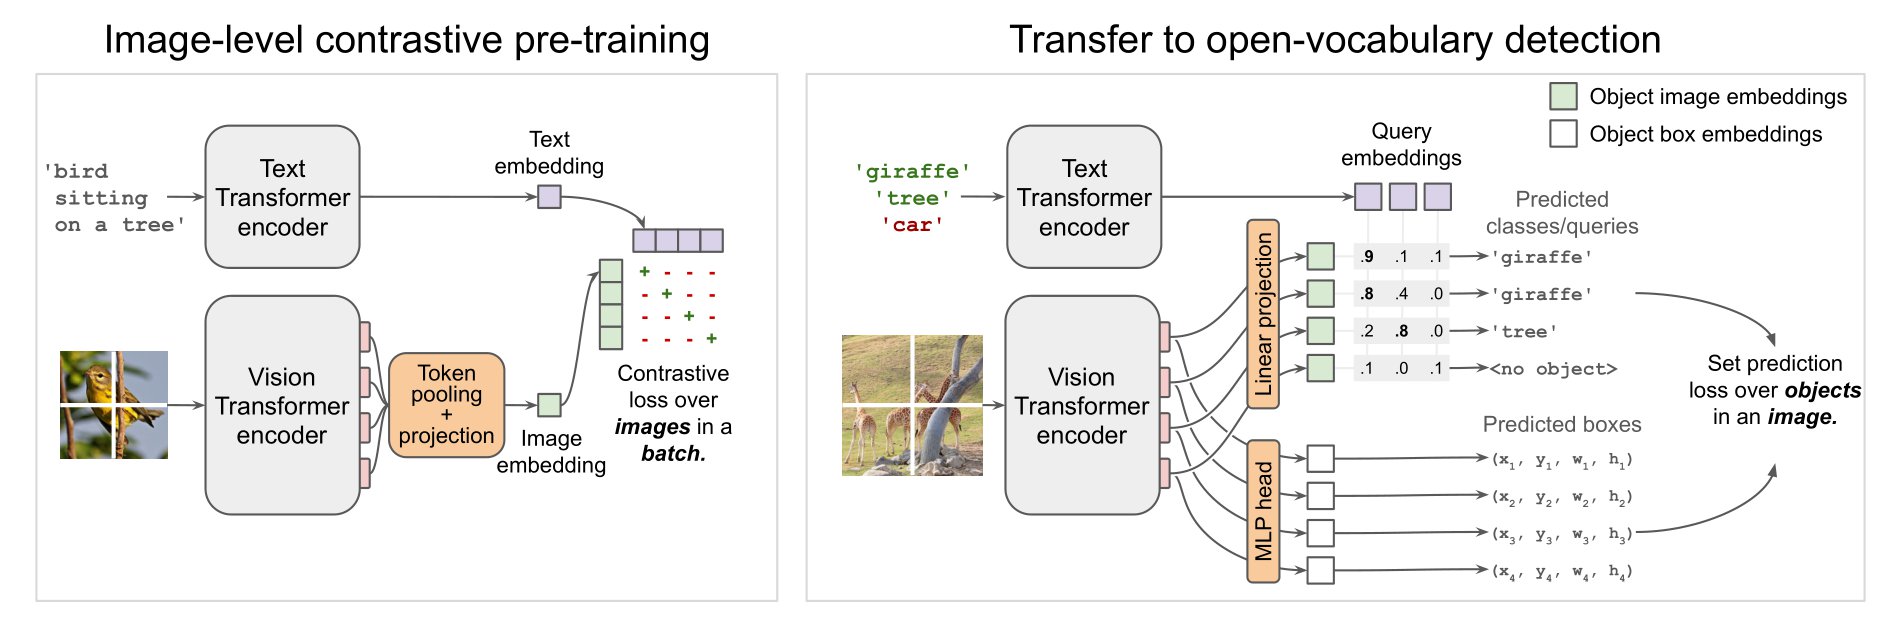 OWL-ViT mimarisi. Orijinal makaleden alınmıştır.
Bu model [adirik](https://huggingface.co/adirik) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/google-research/scenic/tree/main/scenic/projects/owl_vit) bulunabilir.
## Kullanım ipuçları
OWL-ViT, sıfır atışlı (zero-shot) metin koşullu nesne algılama modelidir. OWL-ViT, çok modlu omurgası olarak [CLIP](clip) kullanır; görsel özellikleri almak için ViT benzeri bir Transformer ve metin özelliklerini almak için nedensel bir dil modeli kullanır. CLIP'i algılama için kullanmak amacıyla OWL-ViT, görme modelinin son token havuzlama katmanını kaldırır ve her transformer çıktı token'ına hafif bir sınıflandırma ve kutu başlığı ekler. Açık sözlü sınıflandırma, sabit sınıflandırma katmanı ağırlıklarının, metin modelinden elde edilen sınıf adı gömme (embedding) değerleriyle değiştirilmesiyle sağlanır. Yazarlar, CLIP'i baştan eğitir ve ardından standart algılama veri kümelerinde, sınıflandırma ve kutu başlıklarıyla uçtan uca ince ayar yapar; bu süreçte ikili eşleştirme (bipartite matching) kaybı kullanılır. Sıfır atışlı metin koşullu nesne algılama yapmak için görüntü başına bir veya birden fazla metin sorgusu kullanılabilir.
[OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor), model için görüntüleri yeniden boyutlandırmak (veya yeniden ölçeklendirmek) ve normalize etmek için kullanılabilir ve [CLIPTokenizer](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPTokenizer) metni kodlamak için kullanılır. [OwlViTProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTProcessor), [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) ve [CLIPTokenizer](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPTokenizer) bileşenlerini, hem metni kodlamak hem de görüntüleri hazırlamak için tek bir örnekte birleştirir. Aşağıdaki örnek, [OwlViTProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTProcessor) ve [OwlViTForObjectDetection](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTForObjectDetection) kullanarak nesne algılama işleminin nasıl gerçekleştirileceğini göstermektedir.
```python
import requests
from PIL import Image
import torch
from transformers import OwlViTProcessor, OwlViTForObjectDetection
processor = OwlViTProcessor.from_pretrained("google/owlvit-base-patch32")
model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch32", device_map="auto")
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
text_labels = [["a photo of a cat", "a photo of a dog"]]
inputs = processor(text=text_labels, images=image, return_tensors="pt").to(model.device)
outputs = model(**inputs)
# Target image sizes (height, width) to rescale box predictions [batch_size, 2]
target_sizes = torch.tensor([(image.height, image.width)])
# Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
results = processor.post_process_grounded_object_detection(
outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
)
# Retrieve predictions for the first image for the corresponding text queries
result = results[0]
boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
for box, score, text_label in zip(boxes, scores, text_labels):
box = [round(i, 2) for i in box.tolist()]
print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.707 at location [324.97, 20.44, 640.58, 373.29]
Detected a photo of a cat with confidence 0.717 at location [1.46, 55.26, 315.55, 472.17]
```
## Kaynaklar
OWL-ViT'nin sıfır ve tek örnek (görsel yönlendirmeli) nesne algılama için kullanımına dair bir demo defterine [buradan](https://github.com/huggingface/notebooks/blob/main/examples/zeroshot_object_detection_with_owlvit.ipynb) erişebilirsiniz.
## OwlViTConfig[[transformers.OwlViTConfig]]
#### transformers.OwlViTConfig[[transformers.OwlViTConfig]]
```python
transformers.OwlViTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, return_dict: bool = True, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/configuration_owlvit.py#L101)
**Parametreler:**
return_dict (`bool`, *isteğe bağlı*, varsayılan `True`) : Düz bir tuple yerine `ModelOutput` (dataclass) döndürülüp döndürülmemesi.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Metin omurgasının yapılandırma nesnesi veya sözlüğü.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Görüntü iskeletinin yapılandırma nesnesi veya sözlüğü.
projection_dim (`int`, *isteğe bağlı*, varsayılan `512`) : Metin ve görme projeksiyon katmanlarının boyutluluğu.
logit_scale_init_value (`float`, *isteğe bağlı*, varsayılan `2.6592`) : *logit_scale* parametresinin başlangıç değeri.
initializer_factor (`float`, *opsiyonel*, varsayılan `1.0`) : Tüm ağırlık matrislerini başlatmak için kullanılan bir çarpan (1 olarak tutulmalıdır, başlatma testleri için dahili olarak kullanılır).
Bu, bir OwlViTModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Owlvit modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılanlarla bir yapılandırma örneklendiğinde, [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16) yapılandırmasına benzer bir yapılandırma elde edilir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
## OwlViTTextConfig[[transformers.OwlViTTextConfig]]
#### transformers.OwlViTTextConfig[[transformers.OwlViTTextConfig]]
```python
transformers.OwlViTTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 0, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/configuration_owlvit.py#L27)
**Parametreler:**
vocab_size (`int`, *isteğe bağlı*, varsayılan `49408`) : Modelin sözlük boyutu. `input_ids` tarafından temsil edilebilecek farklı token sayısını tanımlar.
hidden_size (`int`, *isteğe bağlı*, varsayılan `512`) : Gizli temsillerin boyutu.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `2048`) : MLP temsillerinin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `8`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
max_position_embeddings (`int`, *isteğe bağlı*, varsayılan `16`) : Bu modelin kullanılabileceği en büyük dizi uzunluğu.
hidden_act (`str`, *isteğe bağlı*, varsayılan `quick_gelu`) : Dekoderdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-05`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
attention_dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
initializer_factor (`float`, *opsiyonel*, varsayılan `1.0`) : Tüm ağırlık matrislerini başlatmak için kullanılan bir çarpan (1 olarak tutulmalıdır, başlatma testleri için dahili olarak kullanılır).
pad_token_id (`int`, *isteğe bağlı*, varsayılan `0`) : Sözlükte dolgu için kullanılan token kimliği.
bos_token_id (`int`, *isteğe bağlı*, varsayılan `49406`) : Sözlükte akış başlangıcı için kullanılan token kimliği.
eos_token_id (`Union[int, list[int]]`, *isteğe bağlı*, varsayılan `49407`) : Sözlükte akış sonu için kullanılan token kimliği.
Bu, bir OwlViTModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Owlvit modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılanlarla bir yapılandırma örneklendiğinde, [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16) yapılandırmasına benzer bir yapılandırma elde edilir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import OwlViTTextConfig, OwlViTTextModel
>>> # Initializing a OwlViTTextModel with google/owlvit-base-patch32 style configuration
>>> configuration = OwlViTTextConfig()
>>> # Initializing a OwlViTTextConfig from the google/owlvit-base-patch32 style configuration
>>> model = OwlViTTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## OwlViTVisionConfig[[transformers.OwlViTVisionConfig]]
#### transformers.OwlViTVisionConfig[[transformers.OwlViTVisionConfig]]
```python
transformers.OwlViTVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 768, patch_size: int | list[int] | tuple[int, int] = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/configuration_owlvit.py#L65)
**Parametreler:**
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
num_channels (`int`, *opsiyonel*, varsayılan `3`) : Girdi kanal sayısı.
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `768`) : Her bir görüntünün boyutu (çözünürlüğü).
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `32`) : Her yamanın boyutu (çözünürlüğü).
hidden_act (`str`, *isteğe bağlı*, varsayılan `quick_gelu`) : Dekoderdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-05`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
attention_dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
initializer_factor (`float`, *opsiyonel*, varsayılan `1.0`) : Tüm ağırlık matrislerini başlatmak için kullanılan bir çarpan (1 olarak tutulmalıdır, başlatma testleri için dahili olarak kullanılır).
Bu, bir OwlViTModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Owlvit modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılanlarla bir yapılandırma örneklendiğinde, [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16) yapılandırmasına benzer bir yapılandırma elde edilir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import OwlViTVisionConfig, OwlViTVisionModel
>>> # Initializing a OwlViTVisionModel with google/owlvit-base-patch32 style configuration
>>> configuration = OwlViTVisionConfig()
>>> # Initializing a OwlViTVisionModel model from the google/owlvit-base-patch32 style configuration
>>> model = OwlViTVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## OwlViTImageProcessor[[transformers.OwlViTImageProcessor]]
#### transformers.OwlViTImageProcessor[[transformers.OwlViTImageProcessor]]
```python
transformers.OwlViTImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/image_processing_owlvit.py#L102)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 768, 'width': 768}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 768, 'width': 768}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.48145466, 0.4578275, 0.40821073]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.26862954, 0.26130258, 0.27577711]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
OwlViTImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.OwlViTImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
image_like_kwargs (`dict[str, Any]`, *isteğe bağlı*) : Ek görüntü benzeri girdiler için geliştirici bayrağı; bu girdiler de ön işleme tabi tutulacaktır. Girdileri kwarg olarak geçirmenin çalışmadığı durumlarda kullanın. Örneğin, `preprocess(images, masks=masks)` tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerine `preprocess(images, image_like_inputs={"masks": masks})` kullanılabilir.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
## OwlViTImageProcessorPil[[transformers.OwlViTImageProcessorPil]]
#### transformers.OwlViTImageProcessorPil[[transformers.OwlViTImageProcessorPil]]
```python
transformers.OwlViTImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L108)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 768, 'width': 768}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 768, 'width': 768}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.48145466, 0.4578275, 0.40821073]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.26862954, 0.26130258, 0.27577711]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
OwlViTImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.OwlViTImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
image_like_kwargs (`dict[str, Any]`, *isteğe bağlı*) : Ek görüntü benzeri girdiler için geliştirici bayrağı; bu girdiler de ön işleme tabi tutulacaktır. Girdileri kwarg olarak geçirmenin çalışmadığı durumlarda kullanın. Örneğin, `preprocess(images, masks=masks)` tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerine `preprocess(images, image_like_inputs={"masks": masks})` kullanılabilir.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
#### post_process_object_detection[[transformers.OwlViTImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: OwlViTObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L132)
**Parametreler:**
outputs (`OwlViTObjectDetectionOutput`) : Modelin ham çıktıları.
threshold (`float`, *opsiyonel*, varsayılan 0.1) : Nesne algılama tahminlerini tutmak için skor eşiği.
target_sizes (`torch.Tensor` veya `list[tuple[int, int]]`, *isteğe bağlı*) : Şekli `(batch_size, 2)` olan bir Tensor veya batch'teki her bir görüntünün hedef boyutunu `(height, width)` içeren tuple'ların (`tuple[int, int]`) listesi. Ayarlanmazsa, tahminler yeniden boyutlandırılmaz.
**Dönüş:** `list[Dict]`
Her biri aşağıdaki anahtarları içeren sözlüklerden oluşan bir liste:
- "scores": Görseldeki her tahmin edilen kutu için güven puanları.
- "labels": Modelin görüntüde tahmin ettiği sınıfların indeksleri.
- "boxes": (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde görüntü sınırlayıcı kutuları.
[OwlViTForObjectDetection](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTForObjectDetection)'nin ham çıktısını (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde nihai sınırlayıcı kutulara dönüştürür.
#### post_process_image_guided_detection[[transformers.OwlViTImageProcessorPil.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs, threshold = 0.0, nms_threshold = 0.3, target_sizes = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L188)
**Parametreler:**
outputs (`OwlViTImageGuidedObjectDetectionOutput`) : Modelin ham çıktıları.
threshold (`float`, *isteğe bağlı*, varsayılan 0.0) : Tahmin edilen kutuları filtrelemek için kullanılacak minimum güven eşiği.
nms_threshold (`float`, *opsiyonel*, varsayılan 0.3) : Birbiriyle örtüşen kutular için non-maximum suppression IoU eşiği.
target_sizes (`torch.Tensor`, *isteğe bağlı*) : Şekli (batch_size, 2) olan bir Tensor; her giriş, batch'teki ilgili görüntünün (height, width) değeridir. Ayarlanırsa, tahmin edilen normalize edilmiş sınırlayıcı kutular hedef boyutlara yeniden ölçeklenir. None olarak bırakılırsa, tahminler normalize edilmemiş olarak kalır.
**Dönüş:** `list[Dict]`
Bir sözlükler listesi; her sözlük, modelin tahminine göre batch içindeki bir görüntü için puanları, etiketleri ve kutuları içerir. `OwlViTForObjectDetection.image_guided_detection` tek atışlı nesne algılama yaptığı için tüm etiketler None olarak ayarlanır.
[OwlViTForObjectDetection.image_guided_detection()](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTForObjectDetection.image_guided_detection) çıktısını COCO api'nin beklediği formata dönüştürür.
## OwlViTProcessor[[transformers.OwlViTProcessor]]
#### transformers.OwlViTProcessor[[transformers.OwlViTProcessor]]
```python
transformers.OwlViTProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/processing_owlvit.py#L59)
**Parametreler:**
image_processor (`OwlViTImageProcessor`) : Görüntü işleyici zorunlu bir girdidir.
tokenizer (`CLIPTokenizer`) : Tokenizer zorunlu bir girdidir.
Bir görüntü işleyiciyi ve bir belirteçleyiciyi tek bir işleyicide birleştiren bir OwlViTProcessor oluşturur.
[OwlViTProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTProcessor), [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) ve [CLIPTokenizer](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPTokenizer) işlevlerinin tümünü sunar. Daha fazla bilgi için [~OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) ve [~CLIPTokenizer](/docs/transformers/v5.23.0/tr/model_doc/clip#transformers.CLIPTokenizer) belgelerine bakın.
#### __call__[[transformers.OwlViTProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, query_images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/processing_owlvit.py#L71)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
text (`Union[str, list[str], list[list[str]]]`, *isteğe bağlı*) : Kodlanacak dizi veya dizi topluluğu. Her dizi bir metin veya metin listesi (önceden tokenize edilmiş metin) olabilir. Önceden tokenize edilmiş bir girdi geçirirseniz, toplu girdilerle karışıklığı önlemek için `is_split_into_words=True` değerini ayarlayın.
query_images (`ImageInput`, *isteğe bağlı*) : Görüntü yönlü nesne tespiti için kullanılacak sorgu görüntüleri. Sağlandığında, bu görüntüler ana `images` içinde benzer nesneleri bulmak için görsel sorgu olarak hizmet eder. Sorgu görüntüleri herhangi bir metin komutunu geçersiz kılar ve model metinden görüntüye eşleştirme yerine görüntüden görüntüye eşleştirme yapar.
return_mm_token_type_ids (`bool`, *kwargs*) : Çok modlu yer tutucu token konumlarını gösteren çok modlu token türü kimliklerini döndürüp döndürmeyeceğini belirtir.
return_text_replacement_offsets (`bool`, *kwargs*) : Her çok modlu yer tutucu ve ikamesi için karakter ofsetlerinin döndürülüp döndürülmemesi.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, belirli bir çerçeveye ait tensörleri döndürür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/tr/main_classes/processors#transformers.ProcessingKwargs), *opsiyonel*) : Her modalite (metin, görüntüler, videolar, ses) için ek işleme seçenekleri. Modelle ilgili parametreler yukarıda listelenmiştir; desteklenen argümanların tam listesi için TypedDict sınıfına bakın.
**Dönüş:** [BatchFeature](/docs/transformers/v5.23.0/tr/main_classes/feature_extractor#transformers.BatchFeature)
Aşağıdaki alanlara sahip bir [BatchFeature](/docs/transformers/v5.23.0/tr/main_classes/feature_extractor#transformers.BatchFeature):
- **input_ids** -- Bir modele verilecek token kimliklerinin listesi. `text` değeri `None` olmadığında döndürülür.
- **attention_mask** -- Modelin hangi jetonlara dikkat etmesi gerektiğini belirleyen indeks listesi (`return_attention_mask=True` olduğunda veya *"attention_mask"* `self.model_input_names` içindeyse ve `text` `None` değilse).
- **pixel_values** -- Bir modele verilecek piksel değerleri. `images` `None` olmadığında döndürülür.
- **query_pixel_values** -- Bir modele verilecek sorgu görüntülerinin piksel değerleri. `query_images` `None` olmadığında döndürülür.
#### post_process_grounded_object_detection[[transformers.OwlViTProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: OwlViTObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/processing_owlvit.py#L168)
**Parametreler:**
outputs (`OwlViTObjectDetectionOutput`) : Modelin ham çıktıları.
threshold (`float`, *opsiyonel*, varsayılan 0.1) : Nesne algılama tahminlerini tutmak için skor eşiği.
target_sizes (`torch.Tensor` veya `list[tuple[int, int]]`, *isteğe bağlı*) : Şekli `(batch_size, 2)` olan bir Tensor veya batch'teki her bir görüntünün hedef boyutunu `(height, width)` içeren tuple'ların (`tuple[int, int]`) listesi. Ayarlanmazsa, tahminler yeniden boyutlandırılmaz.
text_labels (`list[list[str]]`, *isteğe bağlı*) : Batch'teki her görüntü için metin etiketlerinin listelerinden oluşan liste. Ayarlanmazsa, çıktıdaki "text_labels" `None` olarak ayarlanır.
**Dönüş:** `list[Dict]`
Her biri aşağıdaki anahtarları içeren sözlüklerden oluşan bir liste:
- "scores": Görseldeki her tahmin edilen kutu için güven puanları.
- "labels": Modelin görüntüde tahmin ettiği sınıfların indeksleri.
- "boxes": (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde görüntü sınırlayıcı kutuları.
- "text_labels": Görüntüdeki her tahmin edilen sınırlayıcı kutu için metin etiketleri.
[OwlViTForObjectDetection](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTForObjectDetection)'nin ham çıktısını (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde nihai sınırlayıcı kutulara dönüştürür.
#### post_process_image_guided_detection[[transformers.OwlViTProcessor.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs: OwlViTImageGuidedObjectDetectionOutput, threshold: float = 0.0, nms_threshold: float = 0.3, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/processing_owlvit.py#L216)
**Parametreler:**
outputs (`OwlViTImageGuidedObjectDetectionOutput`) : Modelin ham çıktıları.
threshold (`float`, *isteğe bağlı*, varsayılan 0.0) : Tahmin edilen kutuları filtrelemek için kullanılacak minimum güven eşiği.
nms_threshold (`float`, *opsiyonel*, varsayılan 0.3) : Birbiriyle örtüşen kutular için non-maximum suppression IoU eşiği.
target_sizes (`torch.Tensor`, *isteğe bağlı*) : Şekli (batch_size, 2) olan bir Tensor; her giriş, batch'teki ilgili görüntünün (height, width) değeridir. Ayarlanırsa, tahmin edilen normalize edilmiş sınırlayıcı kutular hedef boyutlara yeniden ölçeklenir. None olarak bırakılırsa, tahminler normalize edilmemiş olarak kalır.
**Dönüş:** `list[Dict]`
Her biri aşağıdaki anahtarları içeren sözlüklerden oluşan bir liste:
- "scores": Görseldeki her tahmin edilen kutu için güven puanları.
- "boxes": (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde görüntü sınırlayıcı kutuları.
- "labels": `None` olarak ayarlanır.
[OwlViTForObjectDetection.image_guided_detection()](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTForObjectDetection.image_guided_detection) çıktısını COCO api'nin beklediği formata dönüştürür.
## OwlViTModel[[transformers.OwlViTModel]]
#### transformers.OwlViTModel[[transformers.OwlViTModel]]
```python
transformers.OwlViTModel(config: OwlViTConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L813)
**Parametreler:**
config ([OwlViTConfig](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde herhangi bir özel head bulunmayan, ham hidden-states üreten çıplak Owlvit Model.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.OwlViTModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, return_base_image_embeds: bool | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L907)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([OwlViTProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTProcessor), görüntü işleme için [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanır).
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
return_loss (`bool`, *isteğe bağlı*) : Karşıtlık kaybının (contrastive loss) döndürülüp döndürülmeyeceği.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
return_base_image_embeds (`bool`, *isteğe bağlı*) : Temel görsel gömme değerlerinin döndürülüp döndürülmemesi.
**Dönüş:** `OwlViTOutput` veya `tuple(torch.Tensor)`
A `OwlViTOutput` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([OwlViTConfig](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[OwlViTModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *opsiyonel*, `return_loss` `True` olduğunda döndürülür) -- Görsel-metin benzerliği için kontrastif kayıp.
- **logits_per_image** (`torch.Tensor`, şekli `(image_batch_size, text_batch_size)`) -- `image_embeds` ile `text_embeds` arasındaki ölçekli nokta çarpımı puanları. Bu, görsel-metin benzerlik puanlarını temsil eder.
- **logits_per_text** (`torch.Tensor`, şekli `(text_batch_size, image_batch_size)`) -- `text_embeds` ile `image_embeds` arasındaki ölçekli nokta çarpımı puanları. Bu, metin-görsel benzerlik puanlarını temsil eder.
- **text_embeds** (`torch.Tensor`, şekli `(batch_size * num_max_text_queries, output_dim`) -- [OwlViTTextModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTTextModel)'ün havuzlanmış çıktısına projeksiyon katmanının uygulanmasıyla elde edilen metin gömme değerleri.
- **image_embeds** (`torch.Tensor`, şekli `(batch_size, output_dim`) -- [OwlViTVisionModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTVisionModel)'ün havuzlanmış çıktısına projeksiyon katmanının uygulanmasıyla elde edilen gömme değerleri.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) -- [OwlViTTextModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTTextModel)'ün çıktısı.
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) -- [OwlViTVisionModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTVisionModel)'ün çıktısı.
Örnekler:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(text=[["a photo of a cat", "a photo of a dog"]], images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.OwlViTModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L836)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size * num_max_text_queries, sequence_length)`) : Sözlükteki girdi dizisi token'larının indeksleri. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)'a bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([OwlViTConfig](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> import torch
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.OwlViTModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L873)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([OwlViTProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTProcessor), görüntü işleme için [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanır).
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([OwlViTConfig](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> import torch
>>> from transformers.image_utils import load_image
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## OwlViTTextModel[[transformers.OwlViTTextModel]]
#### transformers.OwlViTTextModel[[transformers.OwlViTTextModel]]
```python
transformers.OwlViTTextModel(config: OwlViTTextConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L668)
#### forward[[transformers.OwlViTTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L684)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size * num_max_text_queries, sequence_length)`) : Sözlükteki girdi dizisi token'larının indeksleri. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)'a bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([OwlViTConfig](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[OwlViTTextModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTTextModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoProcessor, OwlViTTextModel
>>> model = OwlViTTextModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## OwlViTVisionModel[[transformers.OwlViTVisionModel]]
#### transformers.OwlViTVisionModel[[transformers.OwlViTVisionModel]]
```python
transformers.OwlViTVisionModel(config: OwlViTVisionConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L763)
#### forward[[transformers.OwlViTVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L777)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([OwlViTProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTProcessor), görüntü işleme için [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanır).
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([OwlViTConfig](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[OwlViTVisionModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTVisionModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, OwlViTVisionModel
>>> model = OwlViTVisionModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## OwlViTForObjectDetection[[transformers.OwlViTForObjectDetection]]
#### transformers.OwlViTForObjectDetection[[transformers.OwlViTForObjectDetection]]
```python
transformers.OwlViTForObjectDetection(config: OwlViTConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L1054)
#### forward[[transformers.OwlViTForObjectDetection.forward]]
```python
forward(input_ids: Tensor, pixel_values: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L1379)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size * num_max_text_queries, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi token'larının dizinleri. Dizinler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)'a bakın. [Girdi kimlikları nelerdir?](../glossary#input-ids).
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([OwlViTProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTProcessor), görüntü işleme için [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanır).
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** `OwlViTObjectDetectionOutput` veya `tuple(torch.Tensor)`
`OwlViTObjectDetectionOutput` veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırma ([OwlViTConfig](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[OwlViTForObjectDetection](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTForObjectDetection) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür)) -- Sınıf tahmini için negatif log-olabilirlik (çapraz entropi) ile sınırlayıcı kutu kaybının doğrusal bir kombinasyonu olarak toplam kayıp. İkincisi, L1 kaybı ve genelleştirilmiş ölçekten bağımsız IoU kaybının doğrusal bir kombinasyonu olarak tanımlanır.
- **loss_dict** (`Dict`, *isteğe bağlı*) -- Bireysel kayıpları içeren bir sözlük. Kayıt tutma için faydalıdır.
- **logits** (`torch.Tensor`, şekli `(batch_size, num_patches, num_queries)`) -- Tüm sorgular için sınıflandırma logitleri (no-object dahil).
- **pred_boxes** (`torch.Tensor`, şekli `(batch_size, num_patches, 4)`) -- Tüm sorgular için normalize edilmiş kutu koordinatları, (center_x, center_y, width, height) olarak temsil edilir. Bu değerler, [0, 1] aralığında normalize edilir ve parti içindeki her bir görüntünün boyutuna göre (olası dolgular göz ardı edilerek) göreli olarak hesaplanır. Normalize edilmemiş sınırlayıcı kutuları almak için `post_process_object_detection()` işlevini kullanabilirsiniz.
- **text_embeds** (`torch.Tensor`, şekli `(batch_size, num_max_text_queries, output_dim`) -- [OwlViTTextModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTTextModel)'ün havuzlanmış çıktısına projeksiyon katmanının uygulanmasıyla elde edilen metin gömme değerleri.
- **image_embeds** (`torch.Tensor`, şekli `(batch_size, patch_size, patch_size, output_dim`) -- [OwlViTVisionModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTVisionModel)'ün havuzlanmış çıktısı. OWL-ViT, görüntüleri bir görüntü yaması (patch) kümesi olarak temsil eder ve her yama için görüntü gömme (embedding) hesaplar.
- **class_embeds** (`torch.Tensor`, şekli `(batch_size, num_patches, hidden_size)`) -- Tüm görüntü yamalarının sınıf gömümlemeleri. OWL-ViT, görüntüleri bir görüntü yaması kümesi olarak temsil eder; toplam yama sayısı (image_size / patch_size)**2'dir.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) -- [OwlViTTextModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTTextModel)'ün çıktısı.
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) -- [OwlViTVisionModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTVisionModel)'ün çıktısı.
Örnekler:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import OwlViTProcessor, OwlViTForObjectDetection
>>> processor = OwlViTProcessor.from_pretrained("google/owlvit-base-patch32")
>>> model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text_labels = [["a photo of a cat", "a photo of a dog"]]
>>> inputs = processor(text=text_labels, images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # Target image sizes (height, width) to rescale box predictions [batch_size, 2]
>>> target_sizes = torch.tensor([(image.height, image.width)])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_grounded_object_detection(
... outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
... )
>>> # Retrieve predictions for the first image for the corresponding text queries
>>> result = results[0]
>>> boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
>>> for box, score, text_label in zip(boxes, scores, text_labels):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.707 at location [324.97, 20.44, 640.58, 373.29]
Detected a photo of a cat with confidence 0.717 at location [1.46, 55.26, 315.55, 472.17]
```
#### image_guided_detection[[transformers.OwlViTForObjectDetection.image_guided_detection]]
```python
image_guided_detection(pixel_values: Tensor, query_pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L1294)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([OwlViTProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTProcessor), görüntü işleme için [OwlViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTImageProcessor) kullanır).
query_pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, height, width)`) : Tespit edilecek sorgu görüntülerinin piksel değerleri. Her hedef görüntü için bir sorgu görüntüsü geçirin.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** `OwlViTImageGuidedObjectDetectionOutput` veya `tuple(torch.Tensor)`
`OwlViTImageGuidedObjectDetectionOutput` veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırma ([OwlViTConfig](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
- **logits** (`torch.Tensor`, şekli `(batch_size, num_patches, num_queries)`) -- Tüm sorgular için sınıflandırma logitleri (no-object dahil).
- **image_embeds** (`torch.Tensor`, şekli `(batch_size, patch_size, patch_size, output_dim`) -- [OwlViTVisionModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTVisionModel)'ün havuzlanmış çıktısı. OWL-ViT, görüntüleri bir görüntü yaması (patch) kümesi olarak temsil eder ve her yama için görüntü gömme (embedding) hesaplar.
- **query_image_embeds** (`torch.Tensor`, şekli `(batch_size, patch_size, patch_size, output_dim`) -- [OwlViTVisionModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTVisionModel)'ün havuzlanmış çıktısı. OWL-ViT, görüntüleri görüntü yamaları (image patches) kümesi olarak temsil eder ve her yama için görüntü gömme (embedding) hesaplar.
- **target_pred_boxes** (`torch.Tensor`, şekli `(batch_size, num_patches, 4)`) -- Tüm sorgular için normalize edilmiş kutu koordinatları, (center_x, center_y, width, height) olarak temsil edilir. Bu değerler, [0, 1] aralığında normalize edilir ve parti içindeki her bir hedef görüntünün boyutuna göre (olası dolgular göz ardı edilerek) göreli olarak hesaplanır. Normalize edilmemiş sınırlayıcı kutuları almak için `post_process_object_detection()` işlevini kullanabilirsiniz.
- **query_pred_boxes** (`torch.Tensor`, şekli `(batch_size, num_patches, 4)`) -- Tüm sorgular için normalize edilmiş kutu koordinatları, (center_x, center_y, width, height) olarak temsil edilir. Bu değerler, [0, 1] aralığında normalize edilmiştir ve parti içindeki her bir sorgu görüntüsünün boyutuna göre (olası dolguları göz ardı ederek) göreli olarak tanımlanır. Normalize edilmemiş sınırlayıcı kutuları almak için `post_process_object_detection()` işlevini kullanabilirsiniz.
- **class_embeds** (`torch.Tensor`, şekli `(batch_size, num_patches, hidden_size)`) -- Tüm görüntü yamalarının sınıf gömümlemeleri. OWL-ViT, görüntüleri bir görüntü yaması kümesi olarak temsil eder; toplam yama sayısı (image_size / patch_size)**2'dir.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) -- [OwlViTTextModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTTextModel)'ün çıktısı.
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) -- [OwlViTVisionModel](/docs/transformers/v5.23.0/tr/model_doc/owlvit#transformers.OwlViTVisionModel)'ün çıktısı.
Örnekler:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import AutoProcessor, OwlViTForObjectDetection
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch16")
>>> model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch16")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> query_url = "http://images.cocodataset.org/val2017/000000001675.jpg"
>>> with httpx.stream("GET", query_url) as response:
... query_image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, query_images=query_image, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model.image_guided_detection(**inputs)
>>> # Target image sizes (height, width) to rescale box predictions [batch_size, 2]
>>> target_sizes = torch.Tensor([image.size[::-1]])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_image_guided_detection(
... outputs=outputs, threshold=0.6, nms_threshold=0.3, target_sizes=target_sizes
... )
>>> i = 0 # Retrieve predictions for the first image
>>> boxes, scores = results[i]["boxes"], results[i]["scores"]
>>> for box, score in zip(boxes, scores):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected similar object with confidence {round(score.item(), 3)} at location {box}")
Detected similar object with confidence 0.856 at location [10.94, 50.4, 315.8, 471.39]
Detected similar object with confidence 1.0 at location [334.84, 25.33, 636.16, 374.71]
```